RAG چیست؟ بررسی معماری و کاربردها
43 بازدید
زمان مطالعه: 18 دقیقه
وقتی مدل زبانی هوش مصنوعی جواب را نمیداند، کجا دنبالش میگردد؟
مدلهای زبانی هوش مصنوعی (Language Model) اطلاعات زیادی در اختیار دارند، اما قرار نیست جواب هر سؤالی را بدانند. ممکن است اطلاعات مورد نیاز ما بعد از آموزش مدل منتشر شده باشد، داخل اسناد یک شرکت قرار داشته باشد یا آنقدر تخصصی باشد که مدل شناخت دقیقی از آن نداشته باشد. در چنین شرایطی، چالش فقط این نیست که مدل چقدر قدرتمند است؛ مهم این است که اطلاعات درست را از کجا به دست میآورد.
اینجا روش RAG وارد ماجرا میشود. ایده اصلی ساده است: قبل از اینکه مدل جواب بدهد، اطلاعات مرتبط با سؤال را از منابعی که در اختیارش قرار دادهایم پیدا کنیم و همراه سؤال به مدل بدهیم. به این ترتیب، مدل برای پاسخ دادن فقط به چیزهایی که قبلاً یاد گرفته وابسته نیست و میتواند از اطلاعات بهروز یا اختصاصی ما هم کمک بگیرد.
RAG چیست؟
RAG مخفف Retrieval-Augmented Generation یا «تولید تقویتشده با بازیابی» است. در این روش، جستوجو و تولید پاسخ کنار هم قرار میگیرند: ابتدا اطلاعات مرتبط با سؤال کاربر از میان منابع مشخص پیدا میشود و بعد مدل زبانی با استفاده از همان اطلاعات، پاسخ را تولید میکند.
یک مثال سادهتر بزنیم. فرض کنید صدها صفحه مستندات فنی درباره یک محصول دارید و میخواهید یک دستیار هوشمند بسازید که به سؤال کاربران درباره آن محصول پاسخ دهد. لازم نیست مدل تمام این اسناد را از قبل بلد باشد. وقتی کاربر سؤالی میپرسد، سیستم میتواند ابتدا بخشهای مرتبط اسناد را پیدا کند و فقط همان اطلاعات را در اختیار مدل بگذارد.
در سادهترین حالت، مسیر RAG اینطور است:
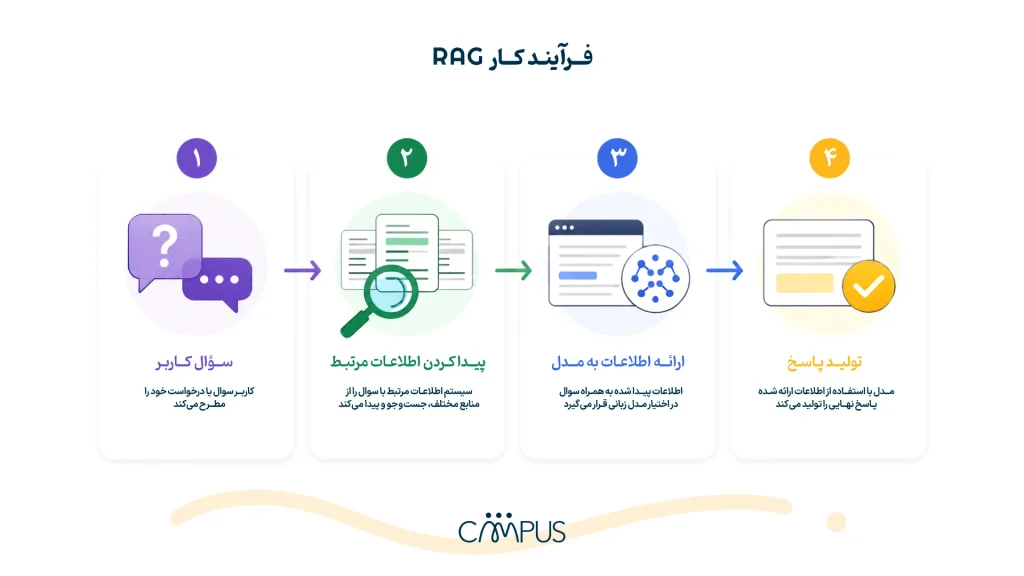
پس RAG قرار نیست مدل را به سیستمی تبدیل کند که همهچیز را از قبل میداند. برعکس، ایده این است که مدل لازم نیست همهچیز را بداند؛ باید بتواند اطلاعات درست را در زمان درست پیدا کند.
همین ایده ساده، پایه معماری RAG است؛ اما برای اینکه ببینیم چرا به چنین روشی نیاز داریم، باید اول محدودیتهایی را بشناسیم که مدلهای زبانی بهتنهایی با آنها روبهرو هستند.
RAG چه مشکلی را در مدلهای زبانی حل میکند؟
یک مدل زبانی میتواند پاسخ قانعکنندهای تولید کند، اما «قانعکننده بودن» همیشه به معنی «درست بودن» نیست. مدل پاسخ خود را بر اساس الگوهایی میسازد که در فرایند آموزش یاد گرفته است و لزوماً به اطلاعاتی که همین حالا برای حل مسئله نیاز داریم، دسترسی ندارد.
این محدودیت در پروژههای واقعی بیشتر خودش را نشان میدهد. فرض کنید میخواهید از یک LLM برای پاسخگویی به سؤالهای کارکنان درباره قوانین داخلی شرکت استفاده کنید. مدل ممکن است درباره قوانین عمومی منابع انسانی اطلاعات داشته باشد، اما از آخرین نسخه آییننامه مرخصی شرکت شما چیزی نمیداند. حتی ممکن است بهجای اعلام اینکه اطلاعات کافی ندارد، پاسخی تولید کند که درست به نظر میرسد اما با سند اصلی مطابقت ندارد؛ رفتاری که با عنوان Hallucination شناخته میشود.
RAG این محدودیت را با یک کار ساده جبران میکند: قبل از اینکه مدل پاسخ بدهد، اطلاعات مرتبط با سؤال را از منابع مشخص پیدا میکند و همان اطلاعات را در اختیار مدل میگذارد.
اگر سؤال کاربر درباره یک قانون داخلی شرکت باشد، سیستم بهجای تکیه صرف بر دانستههای قبلی مدل، ابتدا در اسناد شرکت دنبال بخش مرتبط میگردد. بعد همان بخش را همراه سؤال به مدل میدهد تا پاسخ بر اساس اطلاعات واقعی و مرتبط ساخته شود.
معماری RAG از چه اجزایی تشکیل شده است؟
برای اینکه یک مدل بتواند از اطلاعات بیرونی استفاده کند، صرفاً در اختیار داشتن چند فایل یا اتصال به یک پایگاه داده کافی نیست. سیستم باید اطلاعات را آماده کند، بخشهای مرتبط با سؤال را تشخیص دهد و در نهایت، فقط اطلاعات موردنیاز را در اختیار مدل قرار دهد.
در مثالی که ابتدای این بخش آوردیم، قرار بود دستیار هوشمند از میان صدها صفحه مستندات فنی، اطلاعات لازم برای پاسخ به سؤال کاربر را پیدا کند. حالا ببینیم هرکدام از اجزای RAG در این مسیر چه نقشی دارند و چطور حجم زیادی از اطلاعات در نهایت به چند بخش مرتبط و قابل استفاده برای مدل تبدیل میشود.
۱. منبع داده؛ آجر اول
نقطه شروع، اطلاعاتی است که میخواهیم مدل هنگام پاسخگویی به آنها دسترسی داشته باشد. این اطلاعات میتوانند فایلهای PDF، مستندات فنی، صفحات وب، مقالات، پایگاه دانش سازمان یا دادههای اختصاصی یک پروژه باشند.
کیفیت این منابع مستقیماً روی نتیجه اثر میگذارد. اگر مستندات قدیمی یا ناقص باشند، سیستم هم اطلاعات کاملی برای ساخت پاسخ در اختیار نخواهد داشت. بنابراین قبل از انتخاب مدل یا ابزارهای دیگر، باید مشخص کنیم سیستم قرار است به چه منابعی اعتماد کند.
۲. Chunking؛ تقسیم کردن یک متن یا سند بزرگ به بخشهای کوچکتر و معنادار.
تصور کنید مستندات محصول ۲۰۰ صفحه است و کاربر فقط درباره نحوه تغییر رمز عبور سؤال دارد. منطقی نیست تمام این ۲۰۰ صفحه برای پاسخ به یک سؤال در اختیار مدل قرار بگیرد.
در مرحله Chunking، اسناد به بخشهای کوچکتری تقسیم میشوند تا پیدا کردن قسمت مرتبط با هر سؤال سادهتر شود.
اندازه این بخشها اهمیت دارد. اگر خیلی بزرگ باشند، ممکن است اطلاعات اضافی زیادی همراه پاسخ وارد شوند و اگر بیش از حد کوچک باشند، ارتباط میان جملهها و مفاهیم از بین برود. پس هدف فقط خرد کردن متن نیست؛ باید اطلاعات را طوری تقسیم کنیم که معنای هر بخش تا حد ممکن حفظ شود.
۳. Embedding؛ تبدیل «معنای متن» به یک مجموعه عدد
حالا فرض کنید کاربر میپرسد «چطور رمز عبورم را عوض کنم؟»، اما در مستندات، بخش مربوط به این موضوع با عنوان «تغییر اطلاعات ورود به حساب» نوشته شده است.
اگر جستوجو فقط بر اساس کلمات یکسان انجام شود، ممکن است این ارتباط بهخوبی تشخیص داده نشود. Embedding کمک میکند متنها بر اساس معنای آنها با یکدیگر مقایسه شوند، حتی اگر از کلمات متفاوتی استفاده کرده باشند.
برای این کار، هر بخش از متن به یک نمایش عددی یا «بردار» تبدیل میشود. متنهایی که معنای نزدیکتری دارند، بردارهای مشابهتری هم خواهند داشت. به این ترتیب، سیستم میتواند بخشهایی را پیدا کند که از نظر مفهوم به سؤال کاربر نزدیکترند، نه فقط بخشهایی که همان کلمات را تکرار کردهاند.
۴. پایگاه داده برداری؛ اطلاعات آمادهشده کجا نگهداری میشوند؟
بعد از تبدیل بخشهای متن به بردار، باید آنها را جایی ذخیره کنیم تا هنگام مطرح شدن یک سؤال، بتوان میانشان جستوجو کرد. یکی از گزینههای رایج برای این کار Vector Database یا پایگاه داده برداری است.
وقتی کاربر سؤال جدیدی مطرح میکند، سؤال او هم به یک بردار تبدیل میشود. سپس سیستم آن را با اطلاعات ذخیرهشده مقایسه میکند تا بخشهایی را که از نظر معنایی نزدیکترند پیدا کند.
البته هر سیستم RAG الزاماً به یک پایگاه داده برداری مستقل نیاز ندارد. حجم داده، نوع جستوجو و زیرساخت پروژه مشخص میکند چه روشی برای ذخیره و بازیابی اطلاعات مناسبتر است.
۵. Retriever؛ بازیابیکننده اطلاعات
حالا اطلاعات آماده و قابل جستوجو هستند. Retriever یا بخش بازیابی، وظیفه دارد از میان آنها قسمتهایی را پیدا کند که بیشترین ارتباط را با سؤال کاربر دارند.
مثلاً برای سؤال تغییر رمز عبور، ممکن است از میان هزاران بخش، چند قسمت مرتبط با حساب کاربری، امنیت و اطلاعات ورود انتخاب شوند.
این مرحله تأثیر مستقیمی بر کیفیت نتیجه دارد. اگر اطلاعات مناسبی پیدا نشوند، حتی یک مدل زبانی قدرتمند هم مواد اولیه خوبی برای ساخت پاسخ در اختیار نخواهد داشت.
۶. Reranker؛ انتخاب دقیقتر از بین نتایج بازیابیشده
نتایجی که در مرحله قبل پیدا شدهاند، لزوماً به یک اندازه مفید نیستند. ممکن است چند بخش به موضوع حساب کاربری مربوط باشند، اما فقط یکی از آنها دقیقاً مراحل تغییر رمز عبور را توضیح دهد.
اینجا Reranker نتایج پیداشده را دوباره بررسی و مرتب میکند تا مرتبطترین اطلاعات در اولویت قرار بگیرند. به زبان ساده، مرحله بازیابی میپرسد: «چه اطلاعاتی احتمالاً به این سؤال مربوطاند؟» و مرحله بازرتبهبندی یک قدم جلوتر میرود: «از میان این اطلاعات، کدامیک برای پاسخ دادن مناسبتر است؟»
۷. LLM؛ قدم آخر
در آخر، سؤال کاربر همراه با اطلاعات انتخابشده در اختیار مدل زبانی بزرگ (LLM) قرار میگیرد. حالا مدل بهجای تکیه صرف بر دانستههای قبلی خود، اطلاعات مرتبطی هم در اختیار دارد و میتواند پاسخ را با توجه به آنها تولید کند.
در مثال تغییر رمز عبور، دستورالعمل مرتبط از مستندات محصول پیدا شده و همراه سؤال به مدل رسیده است؛ بنابراین مدل میتواند پاسخ را بر اساس همان مستندات بسازد.
اگر کل مسیر را کنار هم قرار دهیم، معماری RAG در سادهترین حالت چنین جریانی دارد:
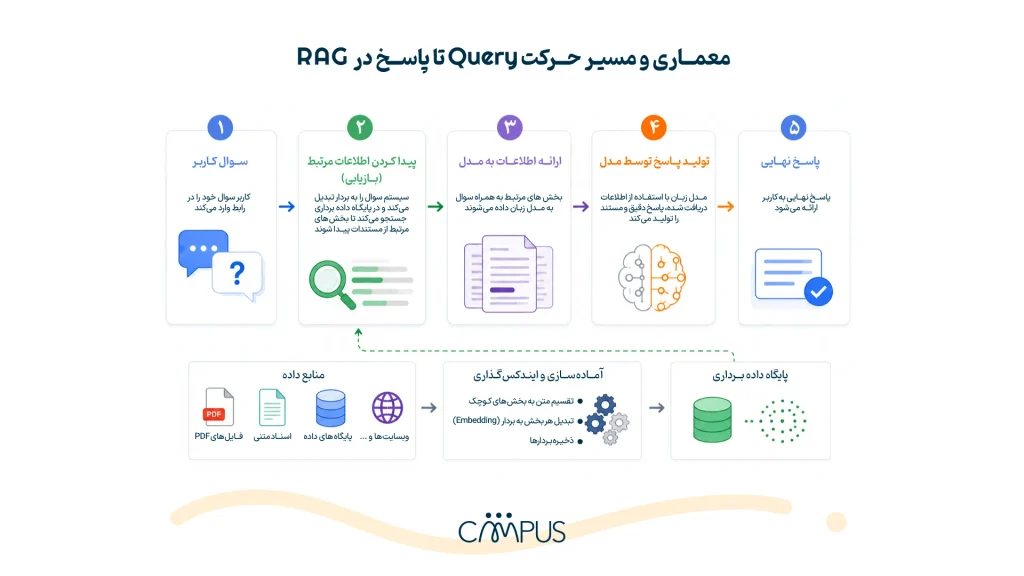
این مسیر یک نکته مهم را نشان میدهد: در RAG، کیفیت پاسخ نتیجه عملکرد کل این زنجیره است، نه فقط آخرین حلقه آن.
RAG چگونه کار میکند؟
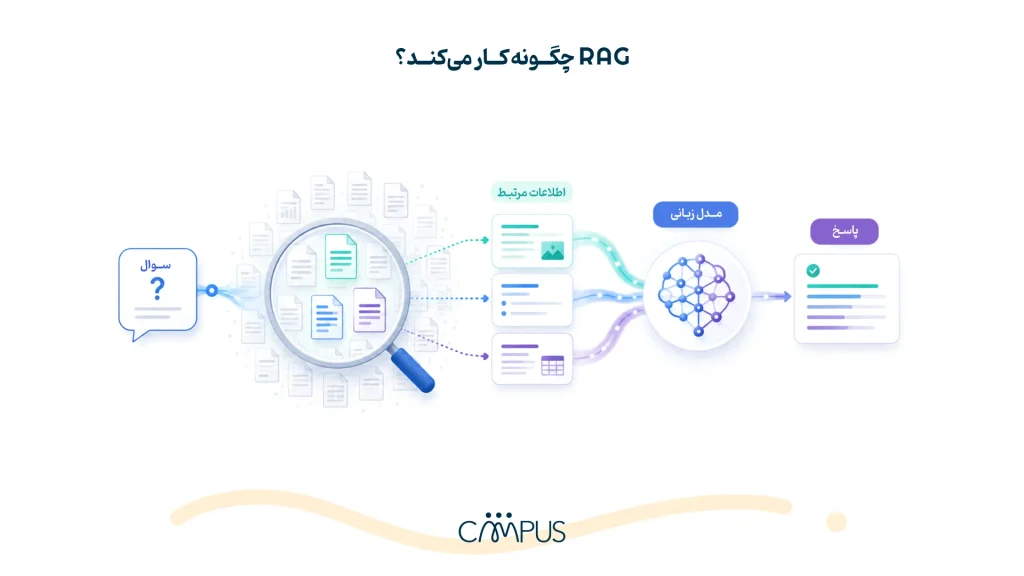
تا اینجا اجزای RAG را جداگانه شناختیم؛ حالا سؤال این است که این اجزا چطور کنار هم قرار میگیرند و یک سؤال را به پاسخ تبدیل میکنند؟
کار RAG را میتوان در دو بخش اصلی دید. بخش اول قبل از مطرح شدن سؤال اتفاق میافتد و اطلاعات را برای جستوجو آماده میکند. بخش دوم از لحظهای شروع میشود که کاربر سؤالش را میپرسد.
قبل از سؤال؛ اطلاعات باید آماده باشند.
قرار نیست هر بار که سؤالی مطرح میشود، تمام اسناد را از ابتدا بخواند. منابع مورد نظر از قبل آماده میشوند: متنها به بخشهای کوچکتر تقسیم میشوند، هر بخش به یک نمایش عددی تبدیل میشود و اطلاعات به شکلی ذخیره میشوند که امکان جستوجوی سریع میان آنها وجود داشته باشد.
این مرحله در واقع زیرساخت بازیابی اطلاعات را میسازد. اگر دادهها از ابتدا درست آماده نشده باشند، پیدا کردن بخش مرتبط با سؤال در مراحل بعد هم دشوارتر میشود. برای درک بهتر مفاهیمی مثل نحوه پردازش دادهها و تشخیص ارتباط میان آنها، میتوانید مقاله «یادگیری ماشین چیست؟» را در فناپ کمپس بخوانید.
بعد از سؤال؛ جستوجو شروع میشود.
با دریافت سؤال کاربر، سیستم باید مشخص کند کدام قسمت از اطلاعات ذخیرهشده میتواند برای پاسخ مفید باشد. سؤال پردازش میشود و بخشهایی که از نظر معنایی به آن نزدیکترند، بازیابی میشوند.
از اینجا تا رسیدن به پاسخ، چند اتفاق اصلی میافتد:
- بخشهای مرتبط از میان اطلاعات موجود پیدا میشوند.
- در صورت نیاز، نتایج دوباره بررسی و مرتب میشوند تا مرتبطترین اطلاعات برای پاسخگویی انتخاب شوند.
- اطلاعات منتخب همراه با سؤال در اختیار مدل زبانی قرار میگیرند.
- مدل با توجه به این اطلاعات، پاسخ نهایی را تولید میکند.
نکته مهم در همین چند مرحله پنهان شده است: مدل قرار نیست خودش دنبال اطلاعات بگردد. سیستم ابتدا اطلاعات مناسب را برایش پیدا میکند و بعد از مدل میخواهد با استفاده از آنها پاسخ بسازد.
کیفیت پاسخ از قبل از LLM شروع میشود.
در یک سیستم RAG، انتخاب مدل زبانی قدرتمند فقط بخشی از کار است. اگر اطلاعات مناسبی بازیابی نشوند، مدل هم زمینه خوبی برای پاسخ دادن ندارد. به همین دلیل، کیفیت یک سیستم RAG را نمیتوان فقط با کیفیت خروجی LLM سنجید.
باید دید آیا:
- منبع اطلاعات معتبر و بهروز است؟
- بخش مرتبط با سؤال بهدرستی پیدا شده؟
- اطلاعات اضافی و نامرتبط وارد زمینه مدل نشدهاند؟
- مدل پاسخ خود را بر اساس اطلاعات بازیابیشده ساخته است؟
به همین دلیل، ساخت RAG بیشتر از آنکه فقط مسئله «انتخاب یک مدل خوب» باشد، مسئله ساختن یک مسیر خوب برای رسیدن اطلاعات درست به مدل است.
انواع RAG؛ از Naive تا Advanced و Modular
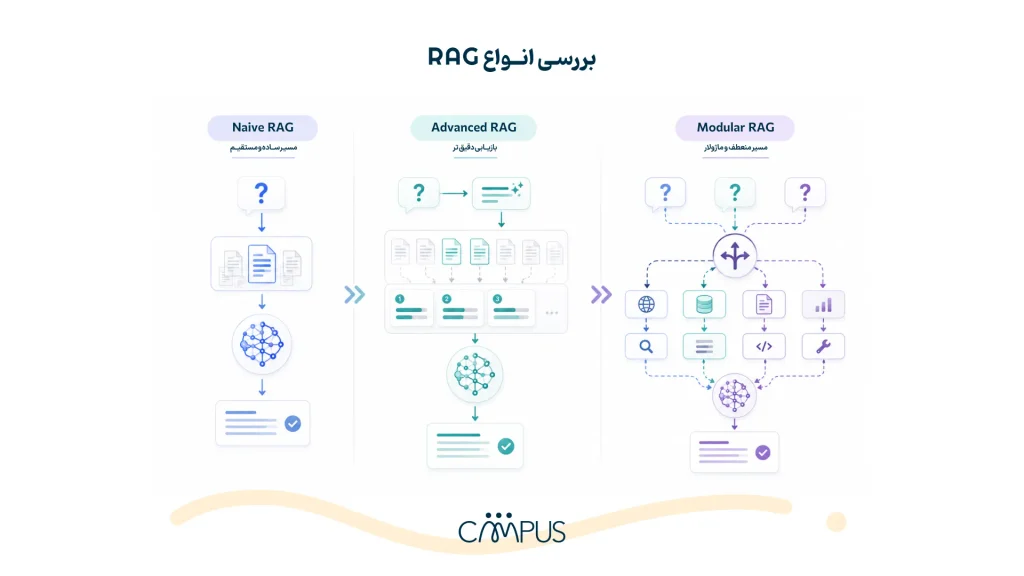
RAG همیشه با یک معماری ثابت اجرا نمیشود. گاهی کافی است اطلاعات مرتبط پیدا شوند و در اختیار مدل قرار بگیرند؛ گاهی هم کیفیت پاسخ آنقدر مهم است که باید روی نحوه جستوجو، انتخاب نتایج و حتی مسیری که اطلاعات طی میکنند، کنترل بیشتری داشته باشیم.
همین تفاوت، ما را به سه رویکرد اصلی میرساند: Naive RAG، Advanced RAG و Modular RAG.
Naive RAG
Naive RAG پایهایترین شکل این معماری است. اطلاعات از قبل آماده و ذخیره میشوند، بخشهای مرتبط با سؤال پیدا میشوند و مدل زبانی با استفاده از آنها پاسخ میدهد.
سادگی، نقطه قوت این روش است؛ بهخصوص برای ساخت نمونه اولیه یا پروژههایی که داده و پرسشهای پیچیدهای ندارند. نقطه ضعف هم تقریباً از همینجا میآید: اگر سیستم اطلاعات مناسبی پیدا نکند، مدل هم ورودی خوبی برای ساخت پاسخ نخواهد داشت.
Advanced RAG
وقتی بازیابی ساده دیگر جوابگوی پروژه نیست، Advanced RAG یک قدم جلوتر میرود. در این روش تلاش میکنیم قبل از رسیدن اطلاعات به مدل، کیفیت آنها را بهتر کنیم.
بسته به نیاز پروژه، این بهبود میتواند شکلهای مختلفی داشته باشد:
- اسناد با روش مناسبتری آماده و تقسیم شوند؛
- سؤال کاربر برای جستوجوی دقیقتر بازنویسی شود؛
- چند روش جستوجو در کنار یکدیگر قرار بگیرند؛
- نتایج پیداشده دوباره بررسی شوند تا مرتبطترین اطلاعات انتخاب شوند.
در واقع، Advanced RAG قرار نیست صرفاً مراحل بیشتری به معماری اضافه کند. قرار است احتمال رسیدن اطلاعات درست به مدل را بیشتر کند.
Modular RAG
در Modular RAG، دیگر لازم نیست هر درخواست دقیقاً از یک مسیر ثابت عبور کند. معماری از بخشهای مختلفی تشکیل میشود که میتوانند متناسب با نوع سؤال و نیاز پروژه در کنار هم قرار بگیرند.
مثلاً ممکن است یک سؤال به جستوجوی اطلاعات نیاز داشته باشد، سؤال دیگری مستقیماً قابل پاسخ باشد و برای یک درخواست پیچیدهتر لازم باشد چند منبع یا روش جستوجو با هم ترکیب شوند.
مزیت اصلی این رویکرد، همین انعطاف است: بهجای اینکه همه سؤالها را وارد یک مسیر از پیش تعیینشده کنیم، مسیر را متناسب با مسئله میسازیم. چنین انعطافی در طراحی بسیاری از سیستمهای پیشرفته هوش مصنوعی اهمیت دارد.
پس قرار نیست همیشه از پیچیدهترین معماری شروع کنیم. اگر یک RAG ساده مسئله را حل میکند، اضافه کردن لایههای بیشتر فقط هزینه و پیچیدگی پروژه را بالا میبرد. زمانی باید سراغ معماریهای پیشرفتهتر رفت که کیفیت بازیابی، تنوع دادهها یا نوع درخواستهای کاربران واقعاً به کنترل بیشتری نیاز داشته باشد.
تفاوت RAG و Fine-tuning چیست؟
RAG و Fine-tuning هر دو میتوانند مدل را برای یک نیاز مشخص مناسبتر کنند، اما مسئله را از دو مسیر متفاوت حل میکنند.
در RAG، دانش مدل تغییر نمیکند؛ اطلاعات مورد نیاز هنگام مطرح شدن سؤال از منابع بیرونی پیدا میشوند و در اختیار مدل قرار میگیرند. در Fine-tuning، مدل با دادههای آموزشی مشخص دوباره تنظیم میشود تا در یک وظیفه، سبک یا رفتار خاص عملکرد مناسبتری داشته باشد.
| نیاز پروژه | انتخاب مناسبتر |
| پاسخ بر اساس اسناد و اطلاعات اختصاصی | RAG |
| استفاده از اطلاعاتی که مرتب بهروزرسانی میشوند | RAG |
| تغییر رفتار، سبک یا عملکرد مدل در یک وظیفه مشخص | Fine-tuning |
| امکان ارجاع پاسخ به منابع مشخص | RAG |
| ترکیب دانش بیرونی با یک مدل شخصیسازیشده | RAG + Fine-tuning |
پس سؤال اصلی این نیست که «RAG بهتر است یا Fine-tuning؟». باید ببینیم چه چیزی را میخواهیم تغییر دهیم: اطلاعاتی که مدل هنگام پاسخ در اختیار دارد یا خودِ رفتار مدل را؟
Fine-tuning همچنین به آمادهسازی داده آموزشی و دانش فنی بیشتری نیاز دارد و بسته به پروژه ممکن است پای متخصصانی مانند Data Scientist هم به فرایند باز شود. در مقابل، اگر مسئله اصلی دسترسی مدل به اطلاعات اختصاصی یا متغیر باشد، RAG نقطه شروع منطقیتری است.
کاربردهای RAG در پروژههای واقعی
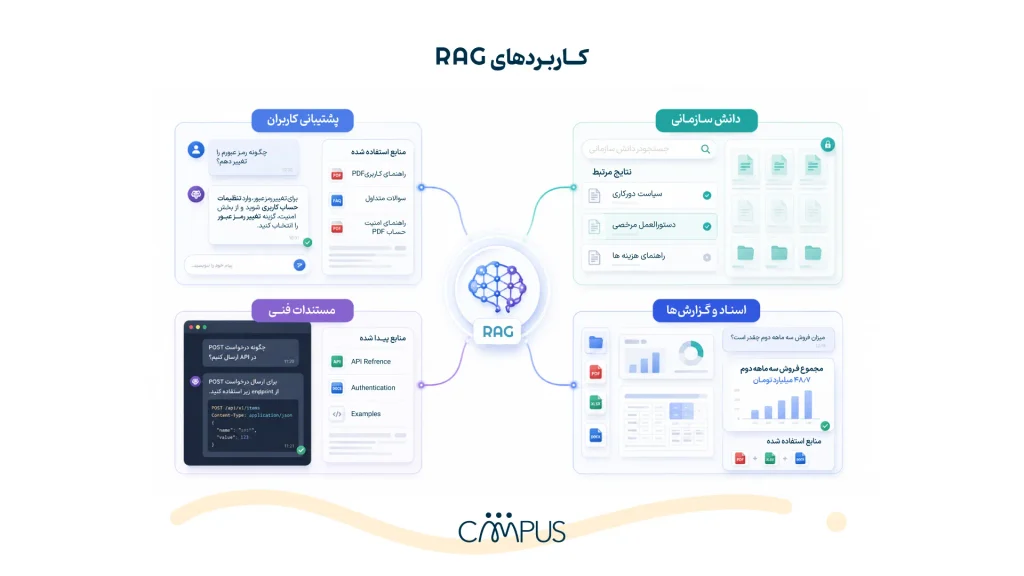
RAG زمانی ارزش واقعی خود را نشان میدهد که مدل باید چیزی بیشتر از دانش عمومیاش بداند؛ مثلاً به مستندات یک محصول، اطلاعات داخلی سازمان یا مجموعه بزرگی از دادههای تخصصی دسترسی داشته باشد.
چند کاربرد رایج آن عبارتاند از:
- دستیارهای پشتیبانی: پاسخ به سؤال کاربران با استفاده از راهنماهای محصول، سؤالات متداول و مستندات پشتیبانی.
- جستوجو در دانش سازمانی: ساخت دستیار داخلی برای پیدا کردن پاسخ از میان آییننامهها، دستورالعملها، مستندات و پایگاه دانش شرکت.
- کار با اسناد تخصصی: استخراج و جمعبندی اطلاعات مرتبط از میان گزارشها، قراردادها، مقالات یا اسناد فنی.
- دستیار توسعهدهندگان: پیدا کردن اطلاعات مرتبط در مستندات فنی، راهنماهای API یا پایگاههای کد و استفاده از آنها برای پاسخ به پرسشهای فنی.
- پرسشوپاسخ روی دادههای تخصصی: در پروژههای تحلیل داده نیز میتوان از RAG برای دسترسی زبانی به گزارشها، مستندات و منابع دانشی مرتبط با دادهها استفاده کرد.
وجه مشترک این کاربردها یک چیز است: اطلاعات مورد نیاز وجود دارد، اما داخل دانش مدل نیست. RAG پلی میان این اطلاعات و مدل زبانی میسازد تا بتوان از دادههای واقعی پروژه در پاسخگویی استفاده کرد.
مزایای RAG
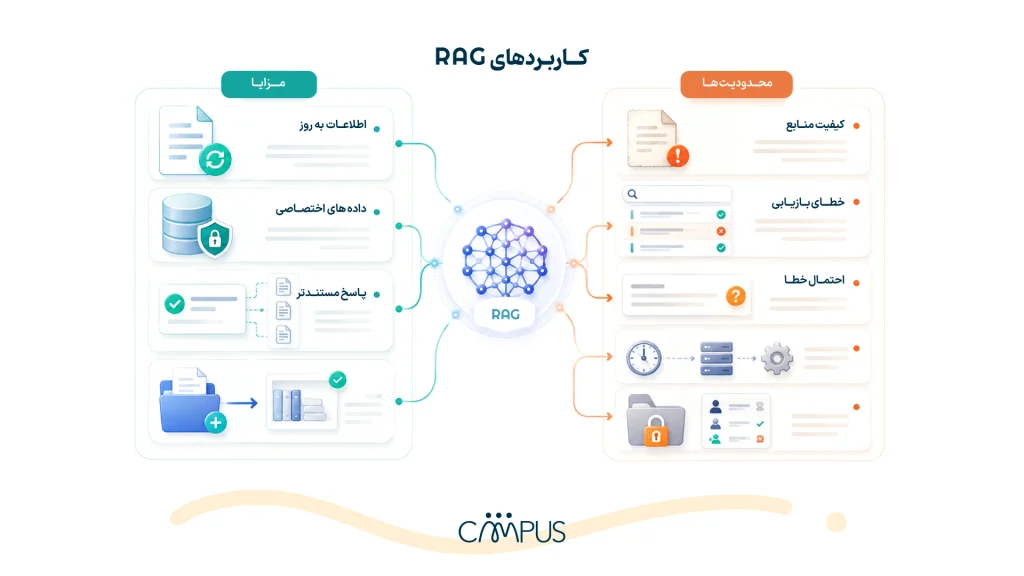
مزیت اصلی RAG این است که مدل برای پاسخدادن فقط به دانشی که در زمان آموزش یاد گرفته محدود نمیماند و میتواند از منابع مشخص و مرتبط با سؤال استفاده کند. این ویژگی چند مزیت مهم ایجاد میکند:
بهروزرسانی اطلاعات بدون آموزش دوباره مدل
با تغییر یا اضافه شدن اسناد و منابع، میتوان اطلاعات در دسترس سیستم را بهروز کرد؛ بدون اینکه برای هر تغییر، مدل دوباره آموزش داده شود. به این ترتیب، بهروزرسانی دانش سیستم به مدیریت منابع اطلاعاتی وابسته میشود، نه آموزش مجدد مدل.
استفاده از اطلاعات اختصاصی
RAG امکان استفاده از منابعی را فراهم میکند که لزوماً بخشی از دادههای آموزشی مدل نبودهاند. مستندات داخلی، پایگاه دانش، فایلهای پروژه و سایر دادههای اختصاصی میتوانند بازیابی شوند و مبنای تولید پاسخ قرار بگیرند.
وابستگی کمتر پاسخ به حافظه مدل
در RAG، اطلاعات مرتبط با سؤال پیش از تولید پاسخ در اختیار مدل قرار میگیرند. در نتیجه، مدل مجبور نیست پاسخ را فقط بر اساس دانشی که از قبل آموخته تولید کند و میتواند از اطلاعات بازیابیشده برای پاسخگویی استفاده کند.
امکان بررسی منبع پاسخ
اگر سیستم برای نمایش منابع طراحی شده باشد، میتوان مشخص کرد پاسخ بر اساس کدام سند یا بخش از اطلاعات تولید شده است. این قابلیت بررسی و ارزیابی پاسخ را برای کاربر سادهتر میکند.
RAG یکی از روشهای استفاده از مدلهای زبانی در محصولات مبتنی بر AI است. اگر هنوز درباره مدلهای زبانی و جایگاه آنها در این حوزه ابهام دارید، در مطلب «هوش مصنوعی چیست؟» این مفاهیم را از پایه توضیح دادهایم.
محدودیتهای RAG
اولین محدودیت به خود اطلاعات برمیگردد. اگر سند اشتباه یا قدیمی باشد، یا بخش نامرتبطی از آن برای مدل انتخاب شود، پاسخ نهایی هم میتواند اشتباه باشد. بنابراین استفاده از RAG بهتنهایی Hallucination را از بین نمیبرد.
پیادهسازی آن نیز چند مرحله به فرایند پاسخگویی اضافه میکند. جستوجو میان دادهها، انتخاب نتایج و آماده کردن اطلاعات برای مدل میتواند روی سرعت و هزینه اجرا اثر بگذارد. در پروژههایی که با اطلاعات خصوصی سروکار دارند، نحوه دسترسی به اسناد و کنترل اینکه چه اطلاعاتی در اختیار چه کاربری قرار میگیرد هم باید از ابتدا در طراحی سیستم دیده شود.
پس RAG بخشی از محدودیت دانش مدل را حل میکند، اما کیفیت پاسخ همچنان به داده خوب، بازیابی دقیق و طراحی درست وابسته است.
برای پیادهسازی RAG به چه ابزارهایی نیاز داریم؟
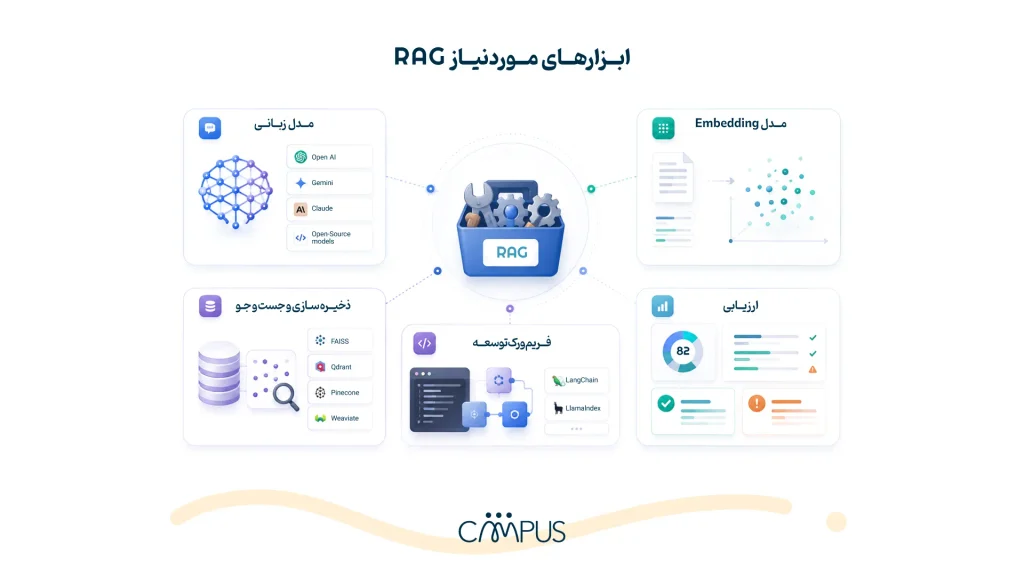
ابزارهای مورد نیاز برای پیادهسازی RAG به معماری پروژه، حجم داده و روشی که برای بازیابی اطلاعات انتخاب میکنیم بستگی دارند. بااینحال، بیشتر پروژهها به چند بخش مشخص نیاز دارند: مدلی برای تولید پاسخ، روشی برای تبدیل و جستوجوی اطلاعات و ابزارهایی که این اجزا را به هم متصل کنند.
ابزارهایی که در این مسیر به کار میآیند عبارتاند از:
- مدل زبانی: برای دریافت اطلاعات بازیابیشده و تولید پاسخ نهایی؛ مانند مدلهای OpenAI، Gemini، Claude یا مدلهای متنباز.
- مدل Embedding: برای تبدیل سؤال و بخشهای مختلف اسناد به بردارهای قابل مقایسه.
- فضای ذخیره و جستوجو: بسته به حجم و نیاز پروژه میتوان از ابزارهایی مانند FAISS یا پایگاههای برداری مانند Qdrant، Pinecone و Weaviate استفاده کرد.
- فریمورکهای توسعه: ابزارهایی مانند LangChain و LlamaIndex میتوانند اتصال منابع داده، فرایند بازیابی و مدل زبانی را سادهتر کنند.
- ابزارهای ارزیابی: برای اینکه مشخص شود سیستم اطلاعات درست را پیدا میکند و پاسخ تولید شده تا چه اندازه با منابع هماهنگ است.
انتخاب از میان این ابزارها به نیاز پروژه برمیگردد. برای یک نمونه اولیه، میتوان با ترکیب سادهتری شروع کرد و بعد بر اساس مشکلاتی که در عمل دیده میشوند، سراغ ابزارها و روشهای پیشرفتهتر رفت. مثلاً اگر نتایج جستوجو دقیق نیستند، قبل از پیچیدهتر کردن کل معماری باید روی بخش بازیابی تمرکز کرد.
اگر میخواهید این مسیر را بهصورت عملی دنبال کنید و یک سیستم RAG بسازید، در دوره RAG فناپ کمپس میتوانید پیادهسازی آن را مرحلهبهمرحله یاد بگیرید.
جمعبندی
RAG زمانی کاربرد پیدا میکند که دانش خود مدل برای پاسخگویی کافی نباشد و بخواهیم اطلاعات مرتبط را از منابع مشخص در اختیار آن قرار دهیم. در این معماری، کیفیت نتیجه فقط به مدل زبانی وابسته نیست؛ نحوه بازیابی اطلاعات، کیفیت منابع و چگونگی استفاده از اطلاعات بازیابیشده هم روی پاسخ نهایی اثر میگذارند.
به همین دلیل، پیادهسازی RAG را نباید صرفاً به اتصال یک مدل زبانی به چند سند خلاصه کرد. یک سیستم RAG زمانی قابل اتکاتر میشود که بتواند اطلاعات مرتبط را درست پیدا کند، آنها را در اختیار مدل قرار دهد و امکان ارزیابی پاسخ را فراهم کند. در نهایت نیز مانند هر سیستم مبتنی بر مدل زبانی، خروجی همچنان باید متناسب با حساسیت کاربرد بررسی و ارزیابی شود.