MongoDB چیست و چگونه کار میکند؟ آشنایی با ساختار و کاربردهای آن
17 بازدید
زمان مطالعه: 12 دقیقه
برای ذخیره اطلاعات در یک نرمافزار، همیشه لازم نیست دادهها در جدولهایی با ساختار ثابت قرار بگیرند. MongoDB یک پایگاه داده NoSQL و سندگراست که اطلاعات را به شکل سندهایی با ساختاری شبیه JSON ذخیره میکند.
این شیوه، دست توسعهدهنده را برای کار با دادههایی که ساختار متفاوت یا متغیری دارند بازتر میگذارد. بااینحال، انتخاب MongoDB به نوع دادهها و نیاز پروژه بستگی دارد. برای تصمیمگیری بهتر، باید با ساختار، ویژگیها و محدودیتهای آن آشنا شویم.
MongoDB چیست؟
MongoDB یک سیستم مدیریت پایگاه داده NoSQL و سندگرا (Document-Oriented) است. برخلاف پایگاههای داده رابطهای که اطلاعات را در جدولهایی شامل سطر و ستون سازماندهی میکنند، در MongoDB هر رکورد به شکل یک Document (سند) ذخیره میشود. هر Document مجموعهای از اطلاعات مرتبط درباره یک مورد مشخص است و میتواند علاوه بر مقادیر ساده، فهرستها و اطلاعات تودرتو را هم در خود نگه دارد.
مثلاً سند مربوط به یک لپتاپ در فروشگاه آنلاین میتواند شامل این اطلاعات باشد:
نام: لپتاپ مدل X
قیمت: ۸۵ میلیون تومان
موجودی: ۱۲ عدد
مشخصات: پردازنده، رم و حافظه داخلی
در این مثال، «مشخصات» میتواند خودش شامل فیلدهای جداگانهای برای پردازنده، رم و حافظه باشد. بنابراین NoSQL بودن MongoDB به معنی بدون ساختار بودن اطلاعات نیست؛ دادهها همچنان باید با منطق مشخصی مدلسازی شوند، اما برای سازماندهی آنها به ساختار ثابت جدولهای رابطهای محدود نیستیم. مقایسه MongoDB با پایگاههای داده رابطهای فقط به «سند در برابر جدول» محدود نمیشود.
دادهها در MongoDB چگونه سازماندهی میشوند؟
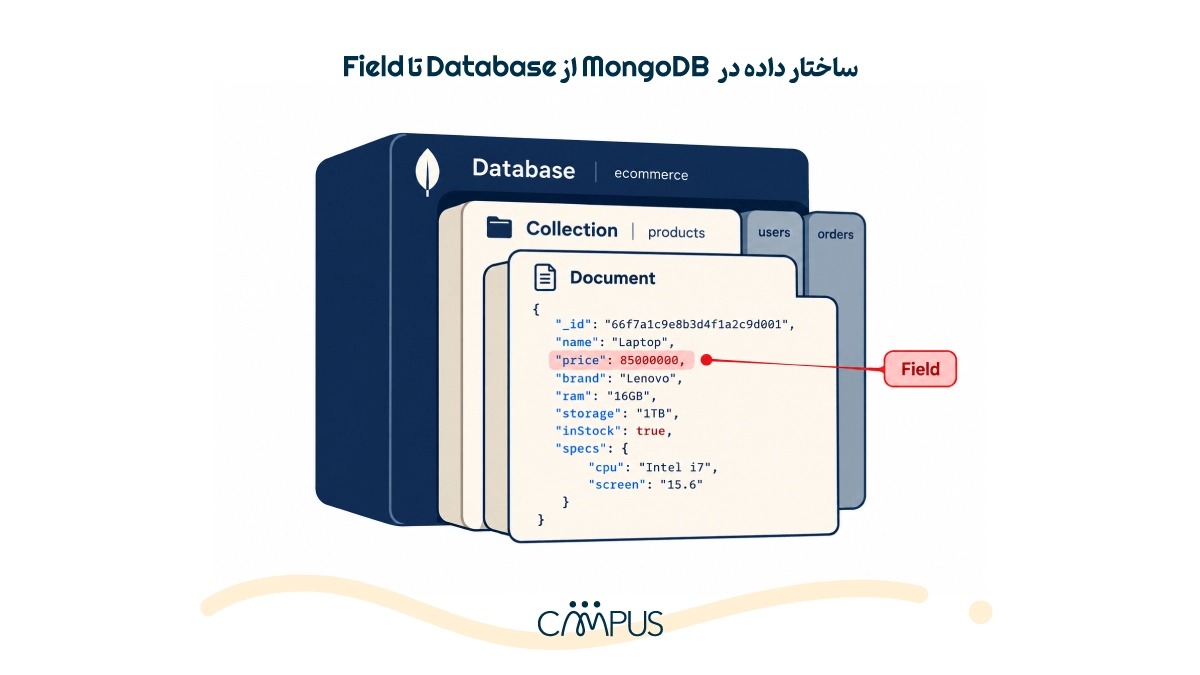
دادهها در MongoDB در چند سطح قرار میگیرند: Database (پایگاه داده)، Collection (مجموعه)، Document (سند) و Field (ویژگی داده). شناخت همین چهار بخش، ساختار MongoDB را تا حد زیادی روشن میکند.
ساختار MongoDB؛ از Database تا Document
Database (پایگاه داده) مجموعهای از اطلاعات مربوط به یک سیستم را در خود نگه میدارد. مثلاً برای یک فروشگاه آنلاین میتوان دیتابیسی داشت که اطلاعات محصولات، کاربران و سفارشها در آن قرار گرفتهاند.
این اطلاعات داخل Collection (مجموعه)های مختلف تفکیک میشوند. مثلاً محصولات در products، کاربران در users و سفارشها در orders قرار میگیرند.
داخل هر Collection هم تعدادی Document داریم. در Collection محصولات، هر Document میتواند اطلاعات یک محصول را نگه دارد. مثلاً سند یک لپتاپ شامل نام، قیمت، موجودی و مشخصات فنی آن است.
تفاوت مهم Collection با جدول اینجاست که همه سندهای یک Collection مجبور نیستند دقیقاً فیلدهای یکسانی داشته باشند. مثلاً یک لپتاپ میتواند فیلد ram داشته باشد و محصول دیگری اصلاً به چنین فیلدی نیاز نداشته باشد.
ساختار فروشگاه در سادهترین حالت اینطور میشود:
Database: فروشگاه
Collection: محصولات
Document: اطلاعات یک لپتاپ
Field: قیمت، موجودی، برند و…
اجزای یک سند؛ BSON، Field و _id
اطلاعات هر Document (سند) از تعدادی Field ساخته میشود. هر فیلد یک نام و یک مقدار دارد. مثلاً در price: 85000000، عبارت price نام فیلد و عدد مقابل آن مقدار است.
مقدار فیلد هم محدود به متن و عدد نیست. میتوان آرایه (فهرستی از چند مقدار)، تاریخ یا حتی یک سند دیگر را داخل یک فیلد قرار داد. همین امکان باعث میشود اطلاعات چندبخشی یک محصول را هم بتوان در یک سند نگه داشت.
MongoDB این سندها را با فرمت (BSON (Binary JSON ذخیره میکند. BSON از نظر ساختار به JSON نزدیک است، اما انواع داده بیشتری را پشتیبانی میکند؛ از جمله انواع مختلف عددی و Date.
هر Document یک فیلد ویژه به نام _id هم دارد. _id شناسه منحصربهفرد آن سند است و MongoDB از آن برای تشخیص سندها از یکدیگر استفاده میکند. اگر هنگام ساخت سند مقداری برای _id تعیین نشود، MongoDB آن را بهصورت خودکار ایجاد میکند.
مدل داده در MongoDB چگونه شکل میگیرد؟
در MongoDB فقط اینکه چه اطلاعاتی ذخیره کنیم مهم نیست؛ باید تصمیم بگیریم دادههای مرتبط را کجا و به چه شکلی نگه داریم. مثلاً مشخصات فنی یک لپتاپ را داخل همان سند محصول قرار دهیم یا آن را جداگانه ذخیره کنیم؟
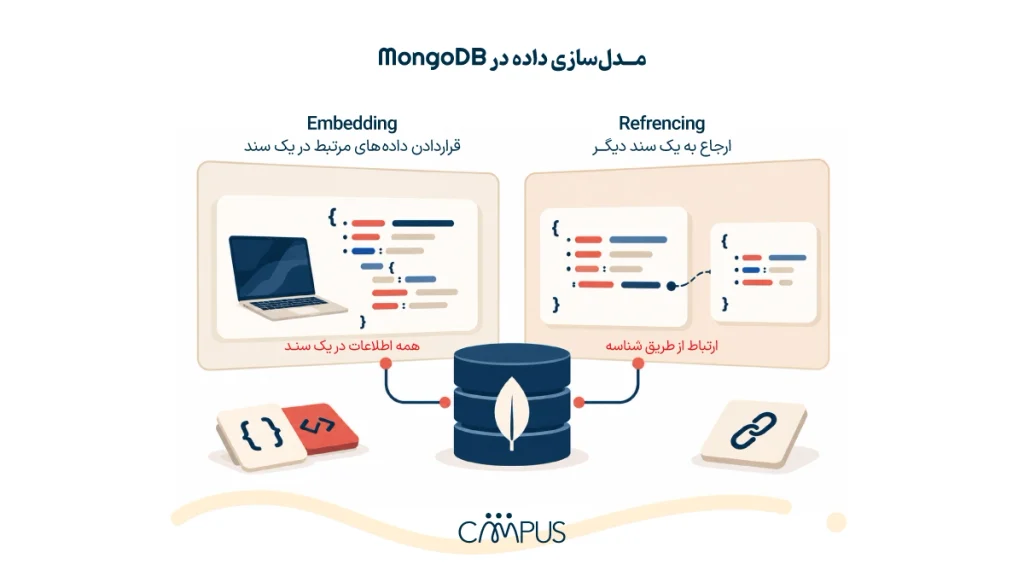
برای چنین تصمیمی در MongoDB دو روش رایج وجود دارد: Embedding (قرار دادن دادههای مرتبط در یک سند) و Referencing (ارجاع به یک سند دیگر).
قرار دادن دادههای مرتبط در یک سند
اگر چند داده معمولاً با هم استفاده میشوند، میتوان آنها را داخل یک Document نگه داشت. مثلاً سند یک لپتاپ میتواند مشخصات فنی آن را هم شامل شود:
نام: لپتاپ مدل X
قیمت: ۸۵ میلیون تومان
مشخصات:
- رم: ۱۶ گیگابایت
- حافظه: ۵۱۲ گیگابایت
- پردازنده: Core i7
در این حالت، با دریافت اطلاعات محصول، مشخصات فنی آن هم در دسترس است و لازم نیست سراغ سند دیگری برویم. به این روش Embedding میگویند.
ارجاع به یک سند دیگر
گاهی یک داده بین چند سند مشترک است و نگهداری چندباره آن منطقی نیست. مثلاً ممکن است دهها محصول در دستهبندی «لپتاپ» قرار داشته باشند. بهجای ذخیره تمام اطلاعات این دستهبندی داخل هر محصول، میتوان دستهبندی را جدا نگه داشت و در سند محصول فقط شناسه آن را ثبت کرد.
به این روش Referencing میگویند. در این حالت، محصول و دستهبندی دو سند جدا هستند، اما از طریق شناسه به یکدیگر ارتباط پیدا میکنند.
هیچکدام از این دو روش همیشه انتخاب درست نیست. اگر اطلاعات با هم خوانده میشوند، نگهداری آنها در یک سند میتواند سادهتر باشد. اگر یک داده بین چند سند مشترک است یا مرتب بهصورت مستقل تغییر میکند، جدا نگه داشتن آن میتواند انتخاب مناسبتری باشد.
چه ویژگیهایی MongoDB را متمایز میکنند؟
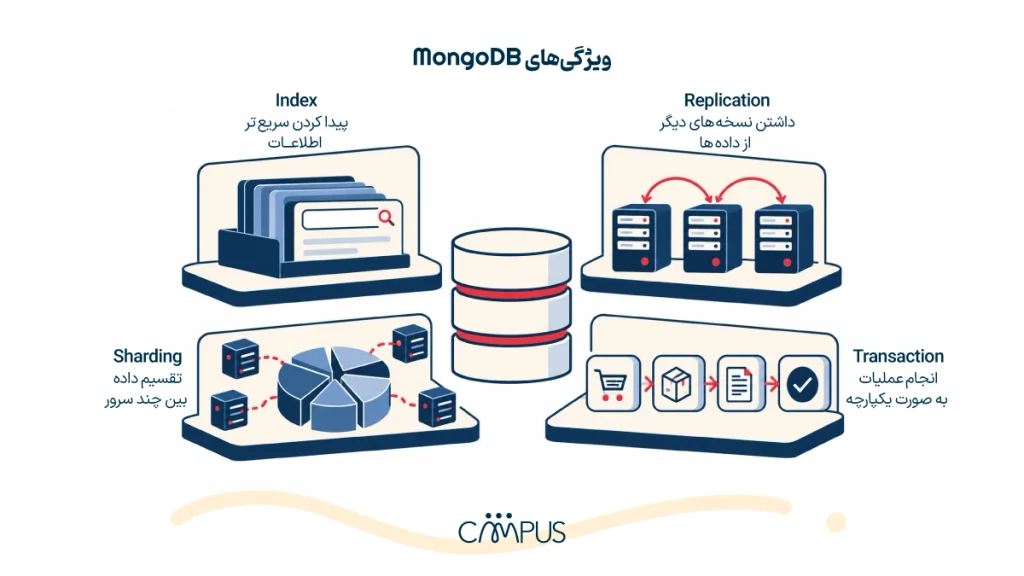
تا اینجا بیشتر درباره شکل ذخیره و مدلسازی دادهها صحبت کردیم، اما MongoDB برای کار با حجم بالاتر داده و پروژههای واقعی، امکانات دیگری هم دارد. Index (نمایه)، Replication (تکثیر داده)، Sharding (تقسیم داده بین چند سرور) و Transaction (تراکنش) از مهمترین مواردی هستند که بهتر است در شروع کار با MongoDB بشناسید.
Index؛ پیدا کردن سریعتر اطلاعات
فرض کنید یک فروشگاه چند صد هزار کاربر دارد و قرار است یک کاربر از روی ایمیلش پیدا شود. بررسی تمام کاربران برای هر جستوجو کار بهینهای نیست. ایندکس کمک میکند MongoDB سریعتر به داده مورد نظر برسد.
البته قرار نیست برای همه فیلدها ایندکس بسازیم. هر ایندکس فضای بیشتری اشغال میکند و هنگام اضافه یا ویرایش اطلاعات هم باید بهروزرسانی شود. به همین دلیل معمولاً برای فیلدهایی ساخته میشود که زیاد در جستوجوها و مرتبسازیها استفاده میشوند.
Replication؛ داشتن نسخههای دیگر از دادهها
اگر اطلاعات فقط روی یک سرور باشند، خرابی همان سرور میتواند دسترسی به پایگاه داده را مختل کند. در Replication چند نسخه از دادهها روی سرورهای مختلف نگهداری میشود.
اگر سرور اصلی از دسترس خارج شود، یکی از سرورهای دیگر میتواند نقش آن را بگیرد. به همین دلیل Replication بیشتر با دسترسپذیری و پایداری پایگاه داده ارتباط دارد.
Sharding؛ تقسیم داده بین چند سرور
وقتی حجم داده یا تعداد درخواستها بالا میرود، ممکن است یک سرور دیگر پاسخگوی نیاز سیستم نباشد. Sharding راهی است برای اینکه دادهها بهجای یک سرور، بین چند سرور پخش شوند.
در نتیجه، همه اطلاعات و درخواستها روی یک سرور متمرکز نمیشوند. این قابلیت بیشتر در پروژههایی اهمیت پیدا میکند که با حجم زیادی از داده یا کاربران روبهرو هستند.
Transaction؛ انجام چند عملیات وابسته بهصورت یکپارچه
بعضی عملیات از چند مرحله تشکیل شدهاند و ناقص ماندن آنها میتواند اطلاعات سیستم را بههم بریزد. Transaction برای چنین موقعیتهایی استفاده میشود.
مثلاً هنگام ثبت سفارش، ممکن است هم سفارش جدید ثبت شود و هم موجودی محصول کاهش پیدا کند. اگر یکی از این عملیات با خطا مواجه شود، نباید سیستم در وضعیتی بماند که سفارش ثبت شده اما موجودی درست نیست.
MongoDB از تراکنش پشتیبانی میکند، اما وجود این قابلیت به این معنی نیست که برای هر سیستم با تراکنشهای پیچیده انتخاب مناسبی است. این موضوع به مدل داده و نوع ارتباط میان اطلاعات پروژه هم بستگی دارد.
مقیاسپذیری MongoDB؛ مدیریت داده در مقیاس بالا
با بیشتر شدن حجم دادهها و تعداد درخواستها، ممکن است یک سرور دیگر برای نگهداری و پردازش همه اطلاعات کافی نباشد. از طرف دیگر، اگر تمام دادهها فقط روی یک سرور باشند، خرابی همان سرور میتواند دسترسی به پایگاه داده را مختل کند.
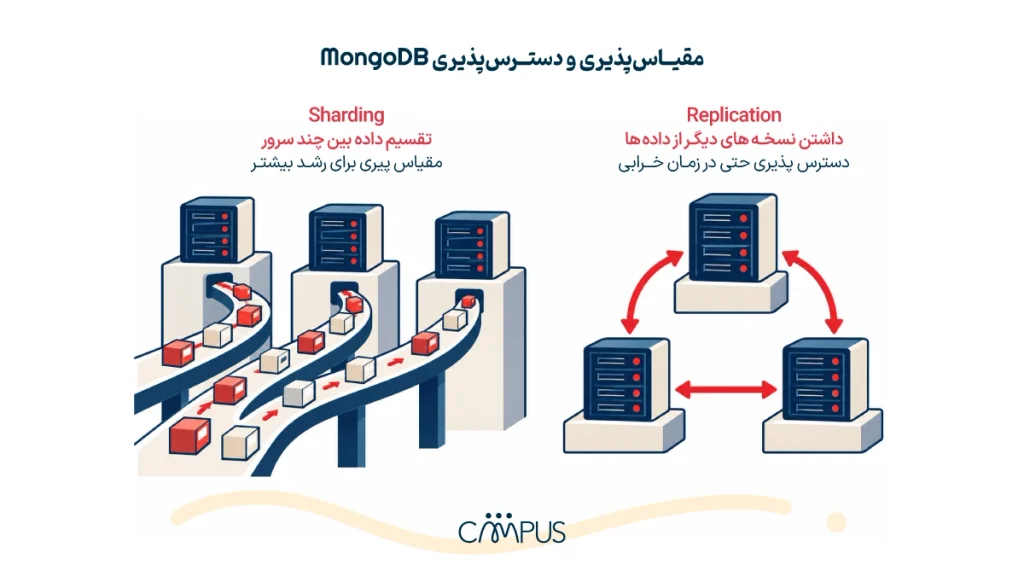
MongoDB برای مدیریت این دو مسئله از Sharding و Replication استفاده میکند.
مقیاسپذیری با Sharding
در Sharding، دادهها بین چند سرور تقسیم میشوند. بهجای اینکه یک سرور مسئول نگهداری تمام اطلاعات باشد، هر بخش از داده روی سرور مشخصی قرار میگیرد.
مثلاً با رشد یک فروشگاه آنلاین، تعداد محصولات، سفارشها و درخواستهای کاربران میتواند آنقدر زیاد شود که نگهداری و پردازش همه آنها روی یک سرور مناسب نباشد. Sharding امکان تقسیم این حجم داده بین چند سرور را فراهم میکند.
MongoDB برای مشخصکردن نحوه تقسیم دادهها از Shard Key (کلید تقسیم داده) استفاده میکند. انتخاب این کلید مهم است، چون تعیین میکند دادهها و درخواستها چطور بین سرورها پخش شوند.
دسترسپذیری با Replication
Replication بهجای تقسیم داده، چند نسخه از آن را نگه میدارد. MongoDB برای این کار از ساختاری به نام Replica Set (مجموعهای از سرورها که نسخههای یکسانی از داده را نگه میدارند) استفاده میکند.
در این ساختار، یک سرور نقش اصلی را دارد و تغییرات روی آن انجام میشود. سرورهای دیگر نسخهای از دادهها را نگه میدارند. اگر سرور اصلی از دسترس خارج شود، یکی از اعضای دیگر میتواند بهصورت خودکار نقش اصلی را برعهده بگیرد.
بنابراین این دو قابلیت هدف یکسانی ندارند: Sharding برای تقسیم داده و مدیریت رشد سیستم است؛ Replication برای کاهش وابستگی به یک سرور و افزایش دسترسپذیری.
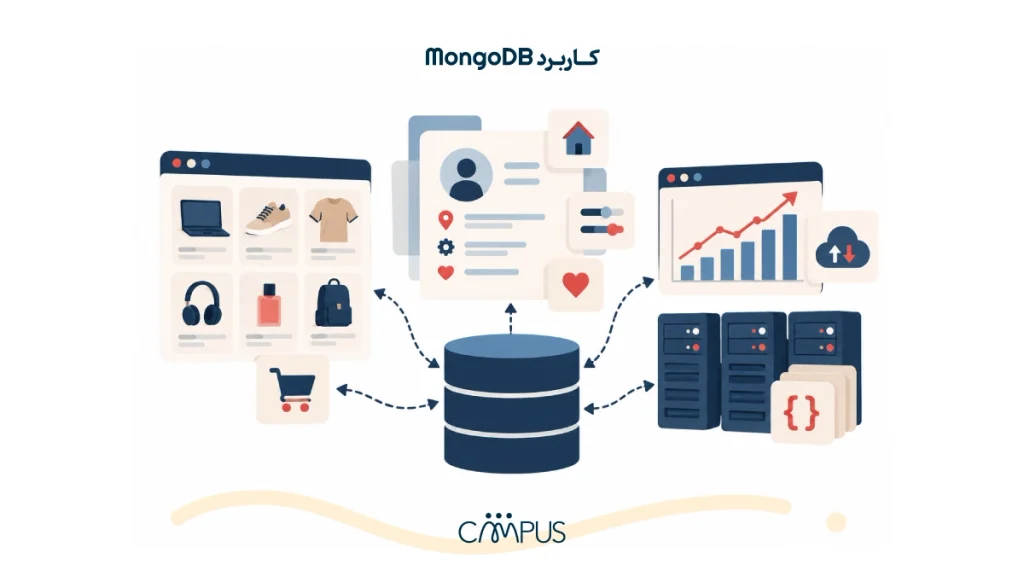
MongoDB در توسعه نرمافزار چه کاربردهایی دارد؟
MongoDB بیشتر زمانی به کار میآید که ساختار دادهها ممکن است تغییر کند، اطلاعات یک شکل ثابت نداشته باشند یا حجم داده با رشد پروژه افزایش پیدا کند. البته نوع پروژه بهتنهایی تعیینکننده نیست؛ مدلی که برای ذخیره و خواندن دادهها نیاز داریم مهمتر است.
کاتالوگ محصولات و محتوا
فروشگاههای آنلاین نمونه خوبی هستند. همه محصولات مشخصات یکسانی ندارند؛ یک لپتاپ با رم، پردازنده و حافظه معرفی میشود، درحالیکه برای یک لباس اطلاعاتی مثل سایز، رنگ و جنس مهم است.
مدل سندگرای MongoDB اجازه میدهد این اطلاعات با ساختارهای متفاوت در یک Collection نگهداری شوند، بدون اینکه برای همه محصولات مجموعه ثابتی از فیلدها تعریف کنیم.
همین ویژگی برای سیستمهای مدیریت محتوا هم کاربرد دارد. مقاله، ویدئو یا پادکست میتوانند اطلاعات متفاوتی داشته باشند و در عین حال بخشی از یک مجموعه محتوایی باشند.
پروفایل کاربران
اطلاعات کاربران هم همیشه به چند فیلد ثابت محدود نمیشود. ممکن است یک پروفایل شامل اطلاعات پایه، آدرسها، تنظیمات حساب و علاقهمندیهای کاربر باشد.
بخشی از این اطلاعات را میتوان در یک سند کنار هم قرار داد؛ بهخصوص زمانی که معمولاً با هم خوانده میشوند. البته اگر اطلاعاتی حجم زیادی داشته باشند یا مستقل از پروفایل تغییر کنند، جداکردن آنها میتواند انتخاب بهتری باشد.
پروژههایی با حجم داده روبهرشد
در سرویسهایی که تعداد کاربران، دادهها یا درخواستها بهمرور افزایش پیدا میکند، قابلیتهایی مثل Sharding و Replication اهمیت بیشتری پیدا میکنند. MongoDB میتواند داده را بین چند سرور تقسیم کند و چند نسخه از آن را نیز نگه دارد؛ قابلیتهایی که در بخش قبل با آنها آشنا شدیم.
کاربرد MongoDB فقط به فروشگاهها یا سیستمهای محتوایی محدود نمیشود و در پروژههایی که با حجم زیادی از داده سروکار دارند هم میتوان سراغ آن رفت. البته انتخاب پایگاه داده فقط یک بخش از ماجراست؛ جمعآوری، آمادهسازی، تحلیل و کار با داده هرکدام مهارتهای دیگری میخواهند. در مسیر یادگیری تحلیل داده میتوانید ببینید این مهارتها چطور در کنار هم یک مسیر تخصصی را میسازند.
مزایا و محدودیتهای MongoDB
انعطاف در ساختار داده و امکان گسترش روی چند سرور از مزیتهای MongoDB هستند، اما انتخاب آن محدودیتهای خودش را هم دارد.
| مزایا | محدودیتها |
| ساختار منعطف برای دادهها | نیاز به مدلسازی درست دادهها |
| امکان نگهداری دادههای مرتبط در یک سند | پیچیدگی بیشتر در ارتباطهای متعدد |
| مقیاسپذیری با Sharding | نیاز به بررسی دقیقتر در تراکنشهای پیچیده و پرتعداد |
| دسترسپذیری بیشتر با Replication | مصرف منابع بیشتر در برخی پیکربندیها |
| پشتیبانی از Index و Transaction | احتمال نامنظم شدن ساختار دادهها در صورت طراحی نادرست |
MongoDB برای چه پروژههایی مناسب است؟
برای انتخاب MongoDB، بهتر است بهجای نوع پروژه به نحوه کار با دادهها نگاه کنید. اگر ساختار اطلاعات در طول توسعه تغییر میکند، همه رکوردها الزاماً فیلدهای یکسانی ندارند یا لازم است دادههای مرتبطی که معمولاً با هم خوانده میشوند در یک سند قرار بگیرند، مدل سندگرای MongoDB میتواند انتخاب مناسبی باشد.
الگوی خواندن و نوشتن دادهها هم در این تصمیم مهم است. طراحی مدل داده در MongoDB تا حد زیادی به این بستگی دارد که برنامه معمولاً چه اطلاعاتی را با هم دریافت میکند و کدام بخشها مستقل از یکدیگر تغییر میکنند. بنابراین نمیتوان صرفاً براساس انعطافپذیری ساختار داده تصمیم گرفت.
در مقابل، اگر بخش اصلی سیستم بر روابط پیچیده میان دادهها یا تراکنشهای چندمرحلهای و پرتعداد متکی است، بهتر است پایگاههای داده رابطهای هم بررسی شوند. MongoDB از تراکنشها و ارتباط میان دادهها پشتیبانی میکند، اما وجود این قابلیتها به این معنا نیست که برای هر نوع ساختار دادهای بهترین گزینه است.
برای تصمیمگیری، سه سؤال میتواند مسیر را روشنتر کند: دادهها چه ساختاری دارند؟ چه ارتباطی با یکدیگر دارند؟ و معمولاً چگونه خوانده یا تغییر داده میشوند؟
شناخت این تفاوتها بخشی از مهارتهای توسعه Backend است. در بخش آموزش برنامهنویسی میتوانید مطالب و دورههای مرتبط با این مسیر را دنبال کنید.
جمعبندی
MongoDB با ساختار سندگرا، انعطاف در مدلسازی داده و قابلیتهایی مثل Sharding و Replication، برای بسیاری از پروژهها گزینه قابلبررسی است. بااینحال، انتخاب آن باید براساس ساختار دادهها و نیاز فنی پروژه انجام شود، نه صرفاً امکاناتی که ارائه میدهد.
قبل از انتخاب MongoDB، بررسی کنید دادهها چه ساختاری دارند، چه ارتباطی میان آنها وجود دارد و پروژه در آینده چقدر قرار است رشد کند. همین چند مورد تا حد زیادی مشخص میکنند MongoDB انتخاب مناسبی برای پروژه شما هست یا نه.