مهندسی پرامپت چیست؟ کاربردها، مهارتهای لازم و نقش آن در آینده مشاغل
39 بازدید
زمان مطالعه: 22 دقیقه
مدلهای زبانی میتوانند کد بنویسند، اطلاعات را تحلیل کنند یا مستندات بسازند؛ اما کیفیت نتیجه فقط به توانایی مدل بستگی ندارد. نحوه تعریف مسئله و چیزی که از مدل میخواهیم، روی کیفیت پاسخ اثر مستقیم دارد.
مهندسی پرامپت (Prompt Engineering) مهارت طراحی و اصلاح ورودی مدلهای هوش مصنوعی برای رسیدن به خروجی دقیقتر و کاربردیتر است. هدف، پیدا کردن چند دستور آماده یا «جمله جادویی» نیست؛ بلکه باید بتوانیم مسئله را طوری برای مدل تعریف کنیم که انتظار ما از نتیجه روشن باشد.
البته پرامپت دقیق، پاسخ درست را تضمین نمیکند. مدل همچنان ممکن است اشتباه کند؛ بنابراین بررسی و راستیآزمایی خروجی بخشی از کار با مدلهای زبانی است.
پرامپت چیست؟
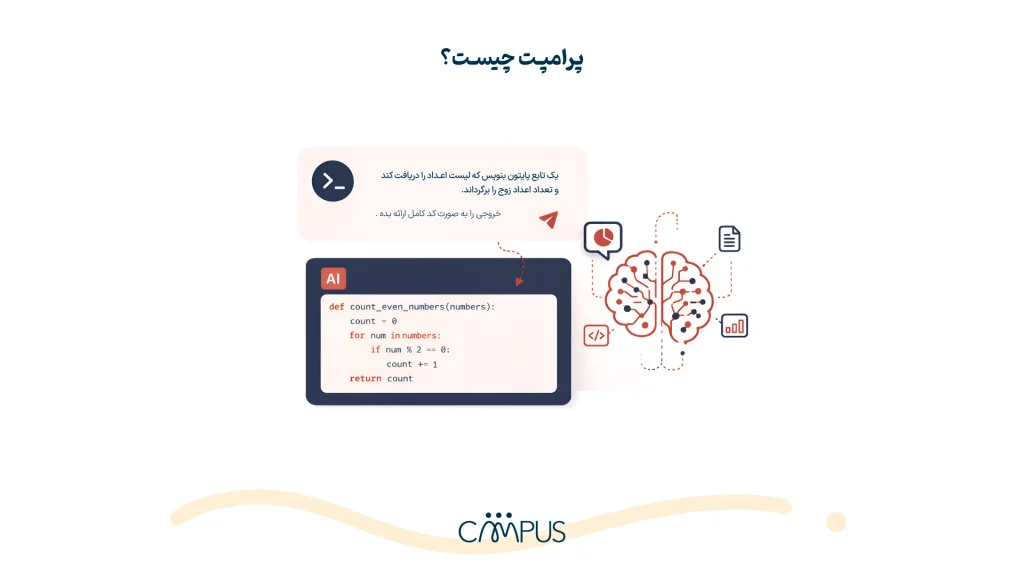
پرامپت ورودیست که برای انجام یک کار به مدل هوش مصنوعی میدهیم. این ورودی لزوماً یک سؤال یا جمله کوتاه نیست؛ میتواند شامل دستور، اطلاعات زمینهای، نمونه، کد، داده، محدودیت و قالب مورد انتظار برای پاسخ باشد.
مثلاً:
«این تابع پایتون را بهینه کن.»
یک پرامپت است، اما مدل اطلاعات زیادی درباره منظور ما ندارد. نمیداند هدف کاهش زمان اجراست یا مصرف حافظه، چه بخشهایی از کد اجازه تغییر دارند و نتیجه باید با چه نسخهای از پایتون سازگار باشد.
حالا اگر همراه همان درخواست، کد فعلی، هدف بهینهسازی، محدودیتهای پروژه و نتیجه موردانتظار را هم مشخص کنیم، فضای کمتری برای برداشتهای متفاوت باقی میماند.
به همین دلیل، پرامپت را میتوان صورت مسئلهای دانست که برای مدل میسازیم. هرچه اطلاعات ضروری این صورت مسئله روشنتر باشند، مدل هم مبنای بهتری برای تولید پاسخ خواهد داشت.
اگر میخواهید قبل از ادامه، شناخت دقیقتری از مدلهای زبانی و جایگاه آنها در این حوزه داشته باشید، در مقاله «هوش مصنوعی چیست» مفاهیم پایه و شاخههای اصلی هوش مصنوعی را توضیح دادهایم.
مهندسی پرامپت چیست؟
مهندسی پرامپت یعنی طراحی هدفمند ورودی مدلهای هوش مصنوعی برای رسیدن به پاسخ دقیقتر و کاربردیتر. در این روش، بهجای اینکه چند دستور مختلف را تصادفی امتحان کنیم، درخواست را بر اساس مسئلهای که میخواهیم حل شود طراحی میکنیم.
مثلاً دستور «این کد را بررسی کن» میتواند برداشتهای مختلفی داشته باشد. آیا مدل باید باگ پیدا کند، مشکلات امنیتی را بررسی کند، خوانایی کد را بهتر کند یا سراغ عملکرد آن برود؟ مهندسی پرامپت کمک میکند چنین ابهامهایی کمتر شوند و مدل تصویر روشنتری از کاری که باید انجام دهد داشته باشد.
در واقع، مهندسی پرامپت بیشتر از اینکه درباره پیدا کردن بهترین جمله برای صحبت با هوش مصنوعی باشد، درباره دقیقتر تعریف کردن مسئله برای مدل است.
مهندسی پرامپت چه تفاوتی با پرامپتنویسی دارد؟
هر بار که برای یک مدل زبانی درخواست مینویسیم، در حال پرامپتنویسی هستیم؛ اما هر پرامپتی حاصل مهندسی پرامپت نیست. تفاوت اصلی در روش رسیدن به خروجی است.
در پرامپتنویسی روزمره معمولاً یک درخواست میفرستیم و بر اساس پاسخی که میگیریم، گفتوگو را ادامه میدهیم. این روش برای بسیاری از کارهای ساده کافی است. مهندسی پرامپت زمانی مطرح میشود که کیفیت خروجی اهمیت بیشتری دارد و لازم است بتوانیم نتیجه را بسنجیم، ایرادهای آن را پیدا کنیم و با تغییر کنترلشده پرامپت، عملکرد مدل را بهتر کنیم.
| پرامپتنویسی | مهندسی پرامپت |
| نوشتن یک درخواست برای مدل | طراحی هدفمند ورودی مدل |
| مناسب بسیاری از کارهای روزمره | مناسب کارهایی که خروجی مشخص و قابلارزیابی میخواهند |
| معمولاً مبتنی بر تعامل مستقیم با مدل | همراه با آزمایش، ارزیابی و اصلاح |
| ممکن است بدون معیار مشخص برای پاسخ انجام شود | معیارهای خروجی از قبل روشنتر تعریف میشوند |
| تمرکز روی دریافت پاسخ | تمرکز روی کیفیت و قابلیت استفاده از پاسخ |
مرز این دو را نباید با تعداد کلمات پرامپت مشخص کرد. یک پرامپت کوتاه میتواند دقیق و حسابشده باشد و یک پرامپت چند پاراگرافی همچنان مبهم باقی بماند. تفاوت اصلی در این است که چقدر آگاهانه ورودی را طراحی کردهایم و آیا راهی برای سنجیدن نتیجه داریم یا نه.
یک پرامپت خوب از چه اجزایی تشکیل میشود؟
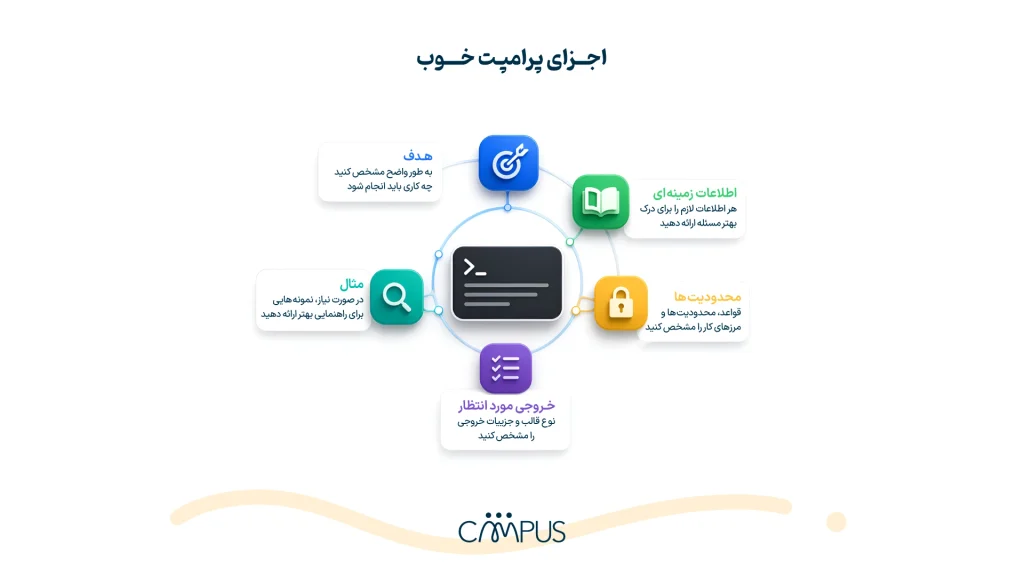
پرامپت خوب الزاماً پرجزئیات نیست؛ اطلاعاتی را در اختیار مدل میگذارد که برای انجام همان کار لازم است. برای یک درخواست ساده شاید یک دستور روشن کافی باشد، اما در مسئلههای فنی معمولاً باید هدف، اطلاعات زمینهای، محدودیتها و شکل خروجی دقیقتر مشخص شوند.
– هدف؛ قرار است به چه نتیجهای برسیم؟
دستورهایی مثل «این معماری را بهتر کن» یا «برای این سرویس API طراحی کن» جهت کلی کار را مشخص میکنند، اما هنوز معلوم نیست دقیقاً چه نتیجهای میخواهیم.
مثلاً بهجای:
«برای سیستم احراز هویت API طراحی کن.»
میتوان نوشت:
«برای سرویس احراز هویت یک REST API طراحی کن که ثبتنام، ورود، تمدید توکن و خروج کاربر را پوشش دهد.»
در نسخه دوم، دامنه کار مشخصتر است و بعد از دریافت پاسخ هم میتوان بررسی کرد که آیا API پیشنهادی تمام نیازهای تعیینشده را پوشش میدهد یا نه.
– Context؛ مدل درباره پروژه چه چیزی باید بداند؟
بخشی از اطلاعاتی که هنگام کار روی یک پروژه برای ما مشخص است، در اختیار مدل نیست. Context یا اطلاعات زمینهای اطلاعاتی است که مدل برای درک بهتر مسئله به آن نیاز دارد.
فرض کنید زمان پاسخ یک سرویس بالا رفته است. اگر مدل بداند سرویس با Node.js اجرا میشود، مشکل بعد از افزایش ترافیک ایجاد شده و درخواستهای کند عمدتاً به یک Query مشخص در PostgreSQL میرسند، مبنای بسیار بهتری برای بررسی علت مشکل خواهد داشت.
Context بسته به مسئله میتواند شامل معماری سیستم، نسخه ابزارها و فریمورکها، اسکیما، مستندات، لاگ، پیام خطا، نیازمندیهای پروژه یا نمونه ورودی و خروجی باشد. البته قرار نیست تمام اطلاعات پروژه وارد پرامپت شوند؛ فقط اطلاعاتی که برای حل همان مسئله لازماند.
– محدودیتها؛ راهحل باید چه مرزهایی را رعایت کند؟
در یک پروژه واقعی، هر راهحلی قابل اجرا نیست. ممکن است نتوانیم Dependency جدیدی اضافه کنیم، نسخه یک فریمورک را تغییر دهیم یا سازگاری با نسخه قبلی سرویس را از دست بدهیم.
مثلاً:
«برای مهاجرت این جدول PostgreSQL راهکار پیشنهاد بده. مهاجرت باید بدون Downtime انجام شود، اسکیما فعلی تا پایان فرایند با نسخه قبلی سرویس سازگار بماند و Primary Key هم تغییر نکند.»
با اضافه شدن این محدودیتها، مدل فقط دنبال یک راهحل فنی نیست؛ باید راهکاری پیشنهاد دهد که با شرایط واقعی پروژه هم سازگار باشد.
– قالب خروجی؛ نتیجه را قرار است چطور استفاده کنیم؟
گاهی پاسخ مدل مستقیماً وارد مرحله دیگری از کار میشود. در چنین شرایطی، مشخص کردن ساختار خروجی میتواند استفاده و ارزیابی نتیجه را سادهتر کند.
مثلاً اگر قرار است لاگهای یک سرویس دستهبندی شوند، میتوان خروجی را بهصورت JSON و با فیلدهای مشخص درخواست کرد:
error_type، severity، probable_cause و recommended_action
یا اگر قرار است بین چند راهکار فنی انتخاب کنیم، میتوان از مدل خواست گزینهها را از نظر پیچیدگی پیادهسازی، مقیاسپذیری و هزینه نگهداری مقایسه کند.
مشخص کردن قالب فقط پاسخ را مرتبتر نمیکند؛ کمک میکند خروجی راحتتر بررسی، مقایسه یا در مرحله بعدی کار استفاده شود.
همه پرامپتها به تمام این اجزا نیاز ندارند. اضافه کردن Context، محدودیت یا قالبی که تأثیری روی نتیجه ندارد، فقط پرامپت را شلوغ میکند. هدف این است که مدل اطلاعات ضروری برای انجام کار را داشته باشد و انتظار ما از نتیجه مبهم نماند.
چگونه یک پرامپت موثر بنویسیم؟
پرامپت مؤثر قبل از هر چیز به یک مسئله روشن نیاز دارد. اگر دقیق ندانیم از مدل چه میخواهیم، اضافه کردن دستورهای بیشتر هم لزوماً نتیجه را بهتر نمیکند. باید درخواست را طوری طراحی کنیم که هم مدل بداند چه کاری دارد و هم خودمان بتوانیم کیفیت پاسخ را بسنجیم.
۱. مسئله را به یک وظیفه مشخص تبدیل کنید.
درخواستهای کلی معمولاً چند برداشت ممکن دارند. قبل از نوشتن پرامپت، مشخص کنید مدل در پایان باید چه کاری انجام داده باشد.
مثلاً:
«برای این API تست بنویس.»
میتواند دقیقتر شود:
«برای endpoint ایجاد سفارش Integration Test بنویس و سناریوهای درخواست معتبر، موجودی ناکافی و کاربر احرازنشده را پوشش بده.»
حالا دامنه کار روشن است و بعد از دریافت پاسخ هم میتوان بررسی کرد که آیا سناریوهای موردنظر واقعاً پوشش داده شدهاند یا نه.
۲. اطلاعات لازم را از اطلاعات اضافی جدا کنید.
مدل باید به اطلاعاتی دسترسی داشته باشد که برای حل مسئله ضروریاند، نه هر چیزی که درباره پروژه در اختیار داریم.
فرض کنید یک سرویس در محیط Production با خطا مواجه شده است. Stack Trace، لاگهای مرتبط، تغییرات اخیر و اطلاعات ضروری محیط اجرا میتوانند به پیدا کردن علت کمک کنند. فرستادن چند فایل کامل یا بخشهای نامرتبط پروژه فقط به این دلیل که «شاید لازم شوند»، الزاماً کمکی به نتیجه نمیکند.
قبل از اضافه کردن هر اطلاعاتی به پرامپت میتوان یک معیار ساده داشت: آیا دانستن این مورد روی تحلیل یا پاسخ مدل اثر میگذارد؟
۳. معیارهای یک پاسخ قابل قبول را مشخص کنید.
درخواستهایی مثل «بهترین راهحل را پیشنهاد بده» یک مشکل دارند: معلوم نیست «بهترین» بر چه اساسی تعیین میشود.
فرض کنید برای یک سرویس پرترافیک باید بین چند راهکار Cache انتخاب کنید. میتوان از مدل خواست گزینهها را از نظر Latency، پیچیدگی پیادهسازی، مقیاسپذیری و هزینه نگهداری مقایسه کند و دلیل پیشنهاد نهایی را هم توضیح دهد.
در این حالت، فقط یک پیشنهاد دریافت نمیکنیم؛ میتوانیم منطق پشت آن را هم بررسی کنیم و ببینیم آیا با شرایط پروژه سازگار است یا نه.
۴. کارهای چندمرحلهای را به یک دستور بزرگ تبدیل نکنید.
اگر از مدل بخواهیم یکجا نیازمندیهای یک فیچر را بررسی کند، راهکار فنی پیشنهاد دهد، پیادهسازی را انجام دهد، تست بنویسد و مستندات آماده کند، تشخیص اینکه مشکل خروجی دقیقاً از کدام مرحله آمده دشوار میشود.
در چنین مسئلههایی بهتر است کار را به مراحل قابل بررسی تقسیم کنیم. ابتدا نیازمندیها و ریسکهای فیچر مشخص شوند، سپس درباره راهکار فنی تصمیم بگیریم و بعد سراغ پیادهسازی و تست برویم.
اگر یکی از مراحل نتیجه مناسبی نداشت، همان قسمت را میتوان اصلاح کرد؛ بدون اینکه کل کار دوباره از ابتدا انجام شود.
۵. اولین پاسخ را ارزیابی کنید، نه اینکه صرفاً بپذیرید.
مدل ممکن است با وجود یک پرامپت دقیق، فرض اشتباهی بسازد، بخشی از درخواست را نادیده بگیرد یا راهحلی پیشنهاد دهد که روی کاغذ درست است اما با پروژه ما سازگار نیست.
بعد از دریافت پاسخ، چند چیز را بررسی کنید:
- آیا تمام نیازهای اصلی پوشش داده شدهاند؟
- آیا مدل فرضی ساخته که در پرامپت وجود نداشته است؟
- محدودیتهای پروژه رعایت شدهاند؟
- راهکار پیشنهادی از نظر فنی قابل اجراست؟
- کد، داده یا ادعاهای فنی نیاز به راستیآزمایی دارند؟
اگر خروجی مناسب نبود، بهجای تغییر تصادفی پرامپت، مشخص کنید مشکل دقیقاً کجاست و همان بخش را اصلاح کنید.
نوشتن پرامپت مؤثر بیشتر شبیه بهبود تدریجی یک راهحل است تا نوشتن یک دستور و تمام. هر خروجی اطلاعات تازهای درباره نقاط مبهم پرامپت به ما میدهد و نسخه بعدی را دقیقتر میکند.
تکنیکهای مهم مهندسی پرامپت
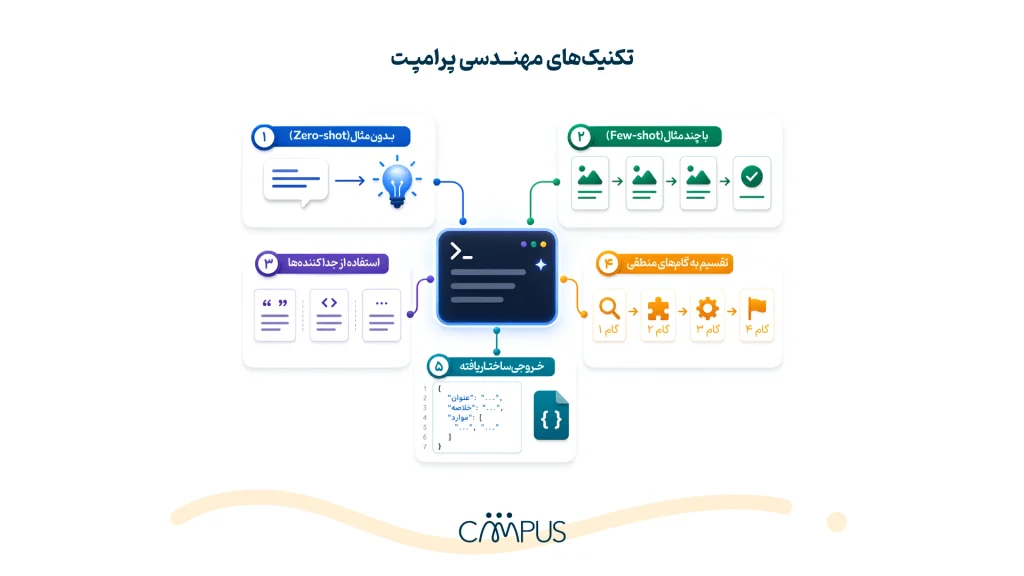
بعد از مشخص شدن مسئله و ساختار پرامپت، میتوان از تکنیکهای مختلف برای هدایت بهتر مدل استفاده کرد. انتخاب تکنیک به نوع کار، پیچیدگی ورودی و خروجی مورد انتظار بستگی دارد؛ بنابراین قرار نیست همه آنها را در یک پرامپت کنار هم قرار دهیم.
Zero-shot Prompting؛ وقتی دستور بهتنهایی کافی است.
در Zero-shot، وظیفه را مستقیماً تعریف میکنیم و نمونهای از پاسخ مطلوب به مدل نمیدهیم. مدل باید بر اساس همان دستور و اطلاعاتی که در اختیارش قرار گرفته، کار را انجام دهد.
برای مسئلهای که هدف و معیارهایش روشن است، معمولاً نیازی نیست از همان ابتدا پرامپت را با نمونهها و دستورهای متعدد سنگین کنیم. از سادهترین نسخهای که مسئله را درست توضیح میدهد شروع میکنیم و فقط در صورت نیاز، جزئیات بیشتری به آن اضافه میکنیم.
Few-shot Prompting؛ وقتی نمونه بهتر از توضیح عمل میکند.
بعضی الگوها را میتوان در چند خط توضیح داد؛ بعضی دیگر با دیدن یک نمونه خیلی سریعتر روشن میشوند. در Few-shot Prompting چند نمونه ورودی و خروجی در اختیار مدل قرار میگیرد تا شکل انجام کار، ساختار پاسخ یا الگوی موردنظر را از آنها تشخیص دهد.
انتخاب نمونه در این روش مهم است. اگر نمونهها مبهم، ضعیف یا با یکدیگر ناسازگار باشند، همان ابهام وارد پاسخ مدل میشود. نمونه قرار است انتظار ما را روشن کند، نه اینکه سؤال تازهای برای مدل بسازد.
شکستن مسئله؛ همهچیز را در یک پرامپت جا ندهید.
یک مسئله چندمرحلهای را میتوان به چند وظیفه کوچکتر و قابل بررسی تقسیم کرد. بهجای اینکه مدل از ابتدا تا انتهای یک فرایند پیچیده را یکجا انجام دهد، خروجی هر مرحله میتواند مبنای مرحله بعد باشد.
این روش یک مزیت مهم دارد: خطا راحتتر پیدا میشود. اگر نتیجه از جایی منحرف شده باشد، میتوان همان مرحله را بررسی و اصلاح کرد، نه اینکه دوباره سراغ کل فرایند برویم.
Structured Output؛ وقتی شکل پاسخ بخشی از نیاز است.
گاهی متن آزاد بهترین خروجی نیست. اگر قرار است پاسخ مدل در برنامه پردازش شود یا وارد مرحله دیگری از یک فرایند شود، ساختار آن هم اهمیت پیدا میکند.
در مدلها و APIهایی که از Structured Output پشتیبانی میکنند، میتوان اسکیما مورد انتظار را تعریف کرد و خروجی را با ساختاری مشخص، مثلاً JSON، دریافت کرد.
اما خروجی خوشساخت لزوماً خروجی درست نیست. ممکن است JSON کاملاً مطابق اسکیما باشد و یکی از مقادیر آن همچنان اشتباه باشد؛ بنابراین اعتبارسنجی محتوا همچنان ضروری است.
تکنیک را برای مسئله انتخاب کنید، نه مسئله را برای تکنیک
Zero-shot یا Few-shot بودن یک پرامپت بهخودیخود نشانه بهتر بودن آن نیست. مدلهای مختلف نیز ممکن است به یک تکنیک یا حتی یک پرامپت یکسان، واکنش متفاوتی نشان دهند.
بهترین روش این است که با ساختار ساده شروع کنیم، خروجی را بسنجیم و فقط وقتی مسئلهای مشخص میبینیم، تکنیکی را به کار بگیریم که همان مسئله را حل میکند. پیچیدهتر شدن پرامپت زمانی ارزش دارد که نتیجه را بهتر کند، نه فقط ظاهر آن را حرفهایتر.
نمونه پرامپت ضعیف و پرامپت بهبودیافته
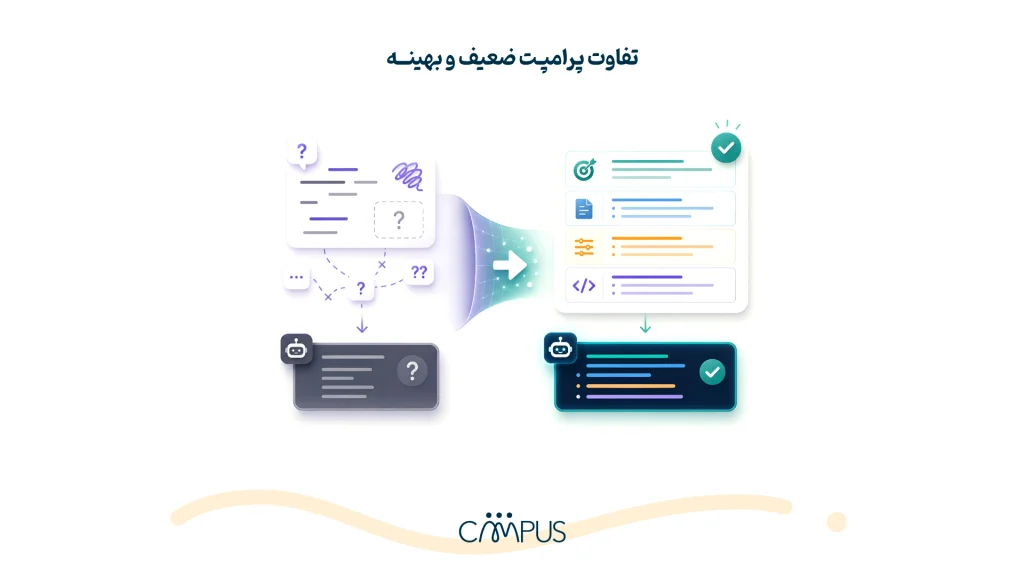
یکی از برداشتهای اشتباه درباره کار با مدلهای هوش مصنوعی این است که هرچه یک پرامپت طولانیتر باشد، نتیجه بهتری تولید خواهد شد. در حالی که کیفیت یک پرامپت بیش از آنکه به طول آن وابسته باشد، به میزان شفافیت، ساختار و اطلاعاتی که درباره مسئله ارائه میکند بستگی دارد.
یک پرامپت ضعیف معمولاً بخش زیادی از مسئله را برای مدل مبهم باقی میگذارد و مدل مجبور میشود برخی جزئیات را بر اساس الگوهای عمومی یا حدس خود تکمیل کند. در مقابل، یک پرامپت بهینه تلاش میکند هدف، زمینه، محدودیتها و نوع خروجی مورد انتظار را مشخص کند تا مدل بتواند پاسخ دقیقتر و مرتبطتری ارائه دهد.
برای درک بهتر این تفاوت، فرض کنید از یک مدل هوش مصنوعی میخواهیم در طراحی دیتابیس یک فروشگاه آنلاین به ما کمک کند.
نمونه پرامپت ضعیف
«برای یک فروشگاه آنلاین دیتابیس طراحی کن.»
این درخواست اگرچه قابل پاسخگویی است، اما اطلاعات کافی برای حل دقیق مسئله در اختیار مدل قرار نمیدهد. مشخص نیست منظور از فروشگاه آنلاین چه نوع سیستمی است، چه نیازهایی باید پوشش داده شود، از چه فناوری یا معماری استفاده خواهد شد و خروجی مورد انتظار در چه سطحی از جزئیات است.
در چنین شرایطی، مدل ناچار است بسیاری از این موارد را خودش فرض کند. ممکن است طراحی پیشنهادی از نظر فنی قابل قبول باشد، اما لزوماً با نیازهای واقعی پروژه هماهنگ نباشد.
نمونه پرامپت بهبودیافته
«برای بخش سفارش یک فروشگاه آنلاین، اسکیما اولیه دیتابیس را در PostgreSQL طراحی کن.
هر سفارش متعلق به یک کاربر است و میتواند شامل چند محصول باشد. قیمت محصول در زمان ثبت سفارش باید مستقل از تغییرات بعدی قیمت ذخیره شود. همچنین وضعیت سفارش باید دارای تاریخچه تغییرات باشد.
جدولهای پیشنهادی، کلیدهای اصلی و خارجی و ارتباط بین جدولها را مشخص کن. از اضافه کردن جدولهایی که برای این نیازها ضروری نیستند خودداری کن. در پایان، تصمیمهای اصلی طراحی و دلیل هرکدام را بهصورت کوتاه توضیح بده.»
در نسخه دوم، اطلاعات بیشتری درباره مسئله در اختیار مدل قرار گرفته است. این اطلاعات باعث میشود مدل به جای ارائه یک طراحی عمومی، مسئله را در چارچوب مشخصتری تحلیل کند.
معیارهای ارزیابی پرامپت
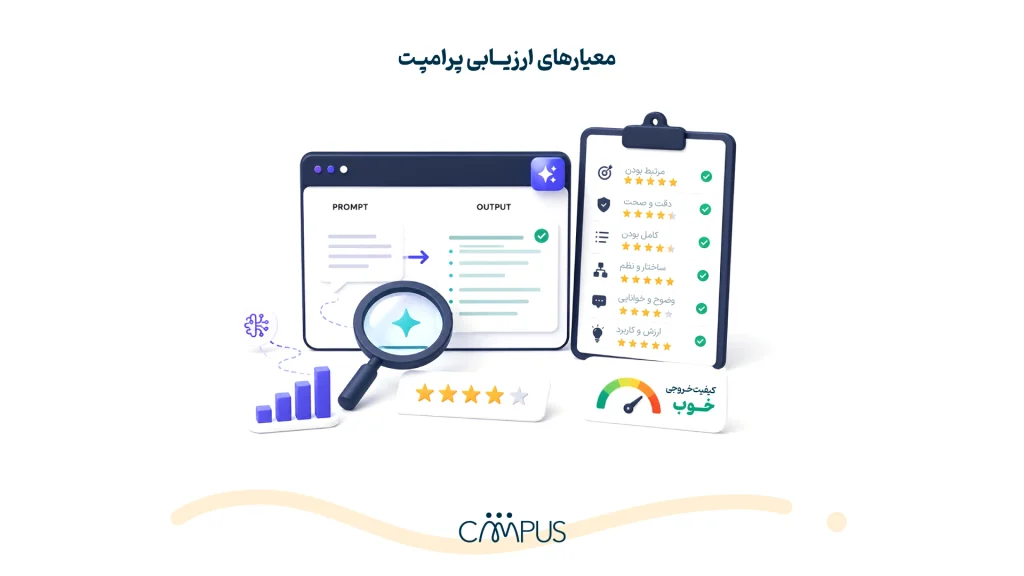
- درستی: آیا اطلاعات، کد و استدلالهای فنی صحیحاند؟
- ارتباط: آیا پاسخ دقیقاً به مسئله مطرحشده مربوط است؟
- کامل بودن: آیا بخشهای ضروری درخواست پوشش داده شدهاند؟
- رعایت محدودیتها: آیا مدل قواعد تعیینشده در پرامپت را رعایت کرده است؟
- قابلیت استفاده: آیا نتیجه در عمل قابل استفاده است؟
- ساختار: آیا خروجی در قالب موردانتظار ارائه شده است؟
اشتباهات رایج در نوشتن پرامپت
گاهی مشکل از توانایی مدل نیست؛ پرامپت از ابتدا اطلاعات یا مسیر روشنی برای رسیدن به نتیجه در اختیار آن نگذاشته است. چند اشتباه رایج میتوانند کیفیت خروجی را پایین بیاورند:
– مبهم نوشتن درخواست
دستورهایی مثل «بهترش کن»، «بررسی کن» یا «کامل توضیح بده» مشخص نمیکنند دقیقاً چه تغییری انتظار داریم. بهتر است هدف یا معیار نتیجه را تا جایی که برای انجام کار لازم است شفاف کنید.
– ندادن اطلاعات زمینهای کافی
مدل فقط بر اساس اطلاعاتی که در اختیار دارد میتواند مسئله را تحلیل کند. اگر نسخه فریمورک، ساختار داده، خطای دریافتی یا یکی از نیازمندیهای اصلی پروژه روی پاسخ اثر میگذارد، آن را در پرامپت ذکر کنید.
– اضافه کردن اطلاعات غیرضروری
اطلاعات بیشتر همیشه به پاسخ بهتر منجر نمیشود. فرستادن فایل، کد، لاگ یا توضیحاتی که ارتباط مستقیمی با مسئله ندارند، میتواند توجه مدل را از بخشهای مهم دور کند؛ بنابراین فقط اطلاعاتی را که برای انجام کار لازماند انتخاب کنید.
– جمع کردن چند وظیفه پیچیده در یک پرامپت
اگر از مدل بخواهید همزمان مسئله را تحلیل کند، راهکار بدهد، کد بنویسد، تست طراحی کند و مستندات بسازد، کنترل کیفیت هر مرحله دشوارتر میشود. در کارهای پیچیده، مسئله را به چند وظیفه مشخصتر تقسیم کنید.
– مشخص نکردن شکل خروجی
اگر قرار است پاسخ در قالب JSON، جدول، کد یا ساختار مشخص دیگری استفاده شود، این انتظار را در پرامپت مشخص کنید. هرجا شکل ارائه نتیجه اهمیت دارد، قالب و جزئیات ضروری خروجی را از ابتدا تعریف کنید.
– اعتماد به اولین پاسخ مدل
پاسخی که کامل و مطمئن به نظر میرسد همچنان ممکن است شامل کد اشتباه، اطلاعات نادرست یا یک فرض نامعتبر باشد. کد را تست کنید، ادعاهای فنی را بررسی کنید و خروجیهای مهم را پیش از استفاده راستیآزمایی کنید.
– یکسان فرض کردن عملکرد پرامپت در مدلهای مختلف
یک پرامپت ممکن است در مدلها یا حتی نسخههای مختلف یک مدل، خروجی یکسانی تولید نکند. اگر قرار است پرامپت بخشی از یک فرایند واقعی باشد، عملکرد آن را روی مدل و سناریوهای موردنظر آزمایش کنید.
در نهایت، بهتر کردن پرامپت همیشه به معنای اضافه کردن جزئیات بیشتر نیست. گاهی حذف یک ابهام یا اطلاعات غیرضروری، نتیجه بهتری ایجاد میکند. در کنار شناخت این اشتباهات، تمرین روی مسئلههای واقعی کمک میکند نحوه کار با مدلها را بهتر یاد بگیرید. در دورههای هوش مصنوعی میتوانید آموزشهای مرتبط با این حوزه را دنبال کنید و مهارتهای خود را در کار با ابزارها و مدلهای AI توسعه دهید.
محدودیتها و نکات امنیتی مهندسی پرامپت
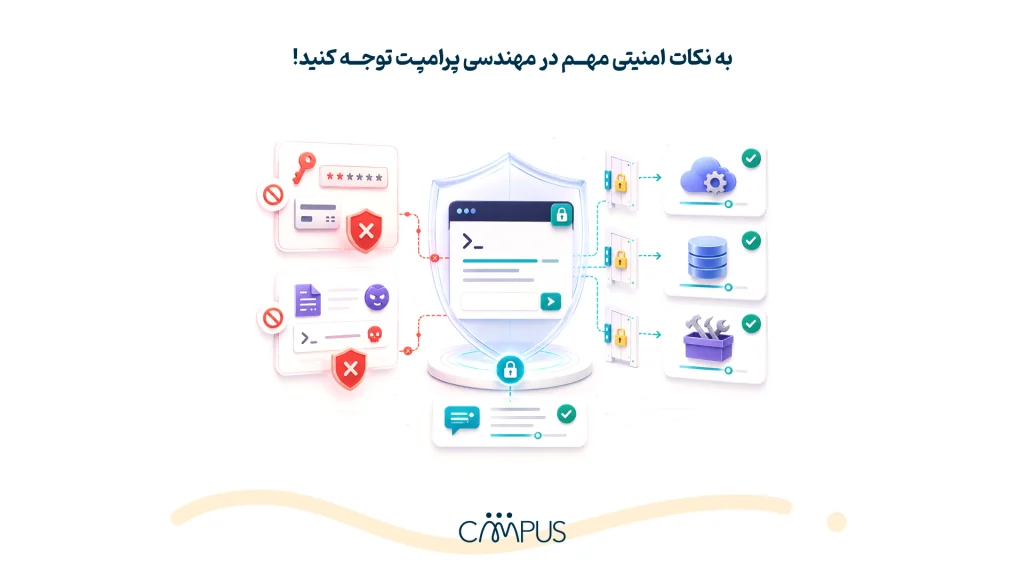
در مهندسی پرامپت فقط مهم نیست چه اطلاعاتی به مدل بدهیم تا پاسخ بهتری بگیریم؛ مهم است چه اطلاعاتی را نباید بدهیم و مدل تا کجا اجازه عمل داشته باشد. وقتی پای کدهای یک پروژه، داده کاربران، اسناد سازمانی یا دسترسی به ابزارهای دیگر در میان است، طراحی پرامپت باید با ملاحظات امنیتی همراه باشد.
هر اطلاعاتی را وارد پرامپت نکنید
برای گرفتن پاسخ دقیقتر، ممکن است وسوسه شویم اطلاعات بیشتری از پروژه در اختیار مدل قرار دهیم؛ اما بخشی از این اطلاعات اصلاً نباید وارد ابزارهای عمومی هوش مصنوعی شوند. از جمله:
- رمز عبور، API Key، Access Token و سایر اطلاعات احراز هویت
- اطلاعات شخصی کاربران
- دادهها و اسناد محرمانه سازمان
- کدهای حساس یا مالکیتی که اجازه اشتراک آنها را ندارید
- اطلاعات حساس مربوط به زیرساخت و تنظیمات امنیتی سیستم
اگر مدل برای انجام کار به اطلاعات زمینهای نیاز دارد، فقط بخش ضروری را در اختیارش قرار دهید و در صورت امکان، اطلاعات حساس را حذف یا ناشناسسازی کنید. سیاستهای امنیتی و محرمانگی سازمان نیز همیشه بر استفاده از ابزارهای عمومی اولویت دارند.
Prompt Injection را جدی بگیرید
Prompt Injection زمانی رخ میدهد که یک ورودی مخرب تلاش کند دستورهای اصلی مدل را تغییر دهد یا آن را به انجام کاری خارج از انتظار سیستم وادار کند.
این حمله همیشه به شکل یک دستور مستقیم از طرف کاربر نیست. ممکن است دستور مخرب داخل یک صفحه وب، فایل، ایمیل یا سندی قرار گرفته باشد که مدل مأمور خواندن و پردازش آن شده است. بنابراین محتوایی که مدل دریافت میکند، صرفاً به دلیل قرار گرفتن در ورودی قابل اعتماد نیست.
نوشتن دستورهایی مثل «دستورهای قبلی را نادیده نگیر» هم بهتنهایی دفاع مطمئنی در برابر Prompt Injection ایجاد نمیکند. ورودی و خروجی باید اعتبارسنجی شوند و میان دستورهای معتبر سیستم و محتوایی که فقط برای پردازش در اختیار مدل قرار گرفته، مرز مشخصی وجود داشته باشد.
دسترسی مدل را به اندازه نیاز نگه دارید
ریسک یک پاسخ اشتباه زمانی بیشتر میشود که مدل فقط تولیدکننده متن نباشد و بتواند به APIها، دیتابیس، فایلها یا ابزارهای دیگر دسترسی پیدا کند.
در چنین شرایطی بهتر است مدل فقط مجوزهایی را داشته باشد که برای انجام همان وظیفه ضروریاند. برای عملیات حساس، مهم یا برگشتناپذیر نیز میتوان تأیید انسانی را پیش از اجرای نهایی در نظر گرفت.
در نهایت، پرامپت فقط یکی از لایههای کنترل یک سیستم مبتنی بر مدل زبانی است. اعتبارسنجی ورودی و خروجی، مدیریت سطح دسترسی، محافظت از اطلاعات حساس و نظارت انسانی در موقعیتهای پرریسک را نمیتوان با یک پرامپت دقیق جایگزین کرد.
آیا Prompt Engineering یک شغل مستقل است؟
عنوان Prompt Engineer این روزها در بحثهای مربوط به مشاغل هوش مصنوعی دیده میشود، اما مهندسی پرامپت فقط به یک عنوان شغلی محدود نیست. در بسیاری از تیمها، طراحی و ارزیابی پرامپت بخشی از کار افرادی است که در توسعه نرمافزار، داده، محصول یا سیستمهای مبتنی بر هوش مصنوعی فعالیت میکنند.
موقعیتهای شغلی مستقلی با عنوان Prompt Engineer هم وجود دارند، اما توانایی نوشتن پرامپت تنها بخشی از مهارتهای موردنیاز برای چنین نقشهایی است. کار با API مدلها، ارزیابی و تست خروجی، شناخت نحوه عملکرد مدلهای زبانی و بسته به پروژه، آشنایی با مفاهیمی مثل RAG و Agentها میتواند در کنار آن قرار بگیرد.
از طرف دیگر، مهندسی پرامپت در مسیرهای شغلی دیگری هم کاربرد دارد. برای مثال، در فرصتهای شغلی Data Scientist یا نقشهای مرتبط با توسعه محصولات AI، توانایی کار هدفمند با مدلهای زبانی در کنار مهارتهای اصلی آن حوزه معنا پیدا میکند؛ نه بهعنوان جایگزین آنها.
پس اگر هدف شما از یادگیری Prompt Engineering ورود به بازار کار است، بهتر است فقط روی «عنوان شغلی» متمرکز نشوید. ارزش این مهارت در ترکیب شدن با تخصص شماست؛ جایی که بتوانید از مدلهای زبانی برای حل یک مسئله واقعی استفاده کنید و کیفیت نتیجه را هم بسنجید.
مسیر یادگیری مهندسی پرامپت؛ از کجا شروع کنیم؟
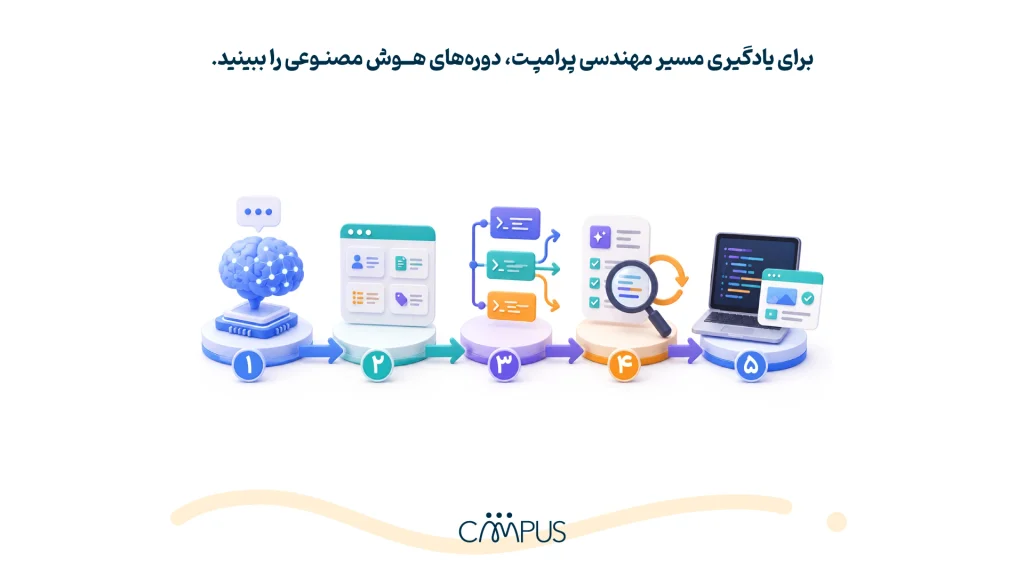
برای یادگیری مهندسی پرامپت، حفظ کردن مجموعهای از قالبها و دستورهای آماده کافی نیست. بخش مهم این مهارت در تمرین شکل میگیرد: مسئله را دقیق تعریف کنید، پرامپت بنویسید، خروجی را بسنجید و بر اساس نتیجه، نسخه بعدی را بهتر کنید.
برای شروع میتوانید این مسیر را دنبال کنید:
۱- با مدلهای زبانی آشنا شوید:
لازم نیست از ابتدا وارد جزئیات پیچیده شوید، اما شناخت کلی LLMها، محدودیتهای آنها و نحوه تولید پاسخ کمک میکند انتظار واقعبینانهتری از مدل داشته باشید.
۲- اصول طراحی پرامپت را تمرین کنید:
تعریف هدف، انتخاب اطلاعات زمینهای، تعیین محدودیت و مشخص کردن خروجی را روی مسئلههای واقعی تمرین کنید. بهجای جمع کردن دهها پرامپت آماده، یاد بگیرید چرا یک پرامپت نتیجه بهتری میدهد.
۳- تکنیکها را در جای درست به کار ببرید:
Zero-shot، Few-shot، Structured Output و شکستن مسئله به مراحل کوچکتر را آزمایش کنید و ببینید هرکدام در چه نوع مسئلهای به کارتان میآیند.
۴- ارزیابی را بخشی از تمرین بدانید:
فقط به گرفتن یک پاسخ خوب اکتفا نکنید. خروجی را با معیار مشخص بررسی کنید، پرامپت را تغییر دهید و نتیجه نسخههای مختلف را با هم بسنجید.
۵- سراغ کاربردهای واقعی بروید:
مهندسی پرامپت زمانی بهتر یاد گرفته میشود که آن را روی مسئلهای واقعی به کار ببرید؛ از کار با کد و داده گرفته تا ساخت قابلیتهایی که از مدلهای زبانی استفاده میکنند.
اگر میخواهید این مهارت را در کنار شناخت گستردهتری از AI پیش ببرید، مسیر یادگیری هوش مصنوعی میتواند ترتیب یادگیری مفاهیم و مهارتهای مرتبط را برایتان روشنتر کند.
مهندسی پرامپت مهارتی نیست که با پیدا کردن یک فرمول ثابت تمام شود. مدلها تغییر میکنند، قابلیتهای تازهای اضافه میشوند و روشهایی که برای یک مدل یا مسئله خوب کار میکنند، ممکن است در شرایط دیگری همان نتیجه را نداشته باشند. مهارت اصلی این است که بتوانید مسئله را درست تعریف کنید، خروجی را بسنجید و روش کارتان با مدل را بر اساس نتیجه اصلاح کنید.
جمعبندی
مهندسی پرامپت بیشتر از اینکه به خوب نوشتن یک درخواست محدود شود، به درست تعریف کردن مسئله، مشخص کردن انتظار از خروجی و ارزیابی نتیجه مربوط است.
یک پرامپت دقیق میتواند ابهام را کمتر کند و مدل را به سمت پاسخ مرتبطتری ببرد، اما مسئولیت بررسی نتیجه همچنان با ماست. مدلها تغییر میکنند، خروجی آنها همیشه قابل پیشبینی نیست و روشی که برای یک مسئله خوب عمل میکند، الزاماً در شرایط دیگر همان نتیجه را نمیدهد.
به همین دلیل، مهندسی پرامپت را بهتر است مهارتی مبتنی بر طراحی، آزمایش و اصلاح بدانیم؛ مهارتی که وقتی با دانش تخصصی یک حوزه ترکیب میشود، کاربرد واقعی خود را نشان میدهد.